
【javascriptエンジニア】リモートワーク率92%/高還元×案件選択制


年収 530万円 ~ 1,000万円
雇用形態: 正社員
勤務地:
Vuex
の転職・求人情報
1~4件(4件)
年収 530万円 ~ 1,000万円
雇用形態: 正社員
勤務地:
年収 500万円 ~ 850万円
雇用形態: 正社員
勤務地:

年収 500万円 ~ 900万円
雇用形態: 業務委託から正社員
勤務地:

年収 500万円 ~ 900万円
雇用形態: 業務委託から正社員
勤務地:
アカウントを作成して、求人情報のブックマークや応募の管理ができます。
求人に関するサマリ
Vuexは、Vue.jsアプリケーションのための状態管理パターンとライブラリです。大規模なシングルページアプリケーション(SPA)の開発において、データの流れを一元管理し、予測可能な方法でアプリケーションの状態を変更するための仕組みを提供します。Vuexを使うことで、複雑なアプリケーションの開発がより簡単になり、保守性も向上します。
Vuexの中核となる考え方は、アプリケーション全体で共有される「単一の真実の源」としてのストアを持つことです。このストアには、アプリケーションの状態(state)が格納され、特定のルールに従ってのみ変更できるようになっています。これにより、データの一貫性が保たれ、バグの発生を抑えることができるんです。
Vuexを使うと、コンポーネント間のデータの受け渡しが簡単になります。親子関係にないコンポーネント間でデータを共有する場合、従来のVue.jsでは複雑な prop の受け渡しが必要でしたが、Vuexを使えばストアを介して簡単にデータを共有できるようになります。これって、結構便利じゃないですか?
Vuexを使う理由はいくつかありますが、主に以下の点が挙げられます。まず、アプリケーションの規模が大きくなるにつれて、コンポーネント間のデータのやり取りが複雑になります。Vuexを使えば、この複雑さを大幅に軽減できるんです。
次に、Vuexを使うことで、アプリケーションの状態管理が一元化されます。これにより、デバッグが容易になり、アプリケーションの動作を予測しやすくなります。例えば、時間旅行デバッグという機能を使えば、状態の変更履歴を追跡し、特定の時点の状態に戻ることができます。これ、めちゃくちゃ便利ですよね。
さらに、Vuexはリアクティブなデータ管理を提供します。ストアの状態が変更されると、その状態を使用しているすべてのコンポーネントが自動的に更新されます。これにより、データの一貫性が保たれ、ユーザーインターフェースとデータの同期が簡単になります。
Stateは、Vuexの中心的な概念の一つです。これは、アプリケーション全体で共有される単一のオブジェクトで、アプリケーションの「状態」を表します。Vuexを使用する際、このStateが唯一の信頼できるデータソースとなります。
Stateは、アプリケーションの様々なデータを保持します。例えば、ユーザー情報、商品リスト、設定など、アプリケーション全体で使用されるデータがここに格納されます。Stateは読み取り専用であり、直接変更することはできません。これにより、データの整合性が保たれるんです。
Stateの値をコンポーネントで使用する際は、computed プロパティを通じてアクセスするのがベストプラクティスです。こうすることで、Stateの変更を監視し、変更があった場合に自動的にビューを更新できます。便利でしょ?
Mutationsは、Stateを変更するための唯一の方法です。これは、Stateを直接変更するのではなく、Mutationsを通じて変更することで、Stateの変更を追跡しやすくし、アプリケーションの動作を予測可能にします。
Mutationsは同期的な操作のみを行うべきです。これは、各Mutationの前後の状態を正確に追跡するためです。非同期操作を行うと、状態の変更タイミングが予測できなくなり、デバッグが困難になる可能性があります。
Mutationsは、タイプ(文字列)とハンドラ(関数)のペアで定義します。ハンドラは第一引数としてStateを受け取り、必要に応じて追加の引数(ペイロード)を受け取ることができます。これにより、Stateの変更を明示的に行うことができるんです。
Actionsは、Mutationsをコミットするためのメソッドです。Mutationsが同期的な操作のみを行うのに対し、Actionsは非同期操作を含む複雑な処理を行うことができます。これにより、アプリケーションのロジックをActionsに集中させることができます。
Actionsは、コンテキストオブジェクトを第一引数として受け取ります。このコンテキストオブジェクトを通じて、StateやGetters、他のActionsにアクセスしたり、Mutationsをコミットしたりすることができます。非同期処理の結果に基づいて、複数のMutationsをコミットすることも可能です。
Actionsは通常、コンポーネントから dispatch メソッドを使って呼び出されます。例えば、APIリクエストを送信し、その結果に基づいてStateを更新するような処理は、Actionsで行うのが適切です。これって、結構便利じゃないですか?
Gettersは、Stateから派生したデータを取得するためのメソッドです。これは、Vueコンポーネントの computed プロパティに似た概念で、Stateの値を加工して返すことができます。Gettersを使うことで、複数のコンポーネントで同じ計算ロジックを再利用できます。
Gettersは、第一引数としてStateを受け取り、オプションで第二引数として他のGettersを受け取ることができます。これにより、複雑な計算や、他のGettersに依存する計算を行うことができます。Gettersの結果はキャッシュされ、依存する値が変更されたときのみ再計算されます。
Gettersを使用することで、コンポーネントのロジックを簡素化し、ビジネスロジックをストアに集中させることができます。例えば、商品リストから特定の条件に合う商品だけをフィルタリングする処理などは、Gettersで行うのが適切です。これにより、コードの再利用性が高まり、保守性も向上します。
Vuexを導入するには、まずプロジェクトにVuexをインストールする必要があります。npm(Node Package Manager)を使用している場合、以下のコマンドでVuexをインストールできます。
npm install vuex@next --save
Vuexをインストールしたら、Vueアプリケーションにストアを追加します。通常、src ディレクトリに store ディレクトリを作成し、その中に index.js ファイルを作成します。このファイルで、Vuexストアを定義し、エクスポートします。
ストアを作成したら、mainアプリケーションファイル(通常は main.js)でストアをインポートし、Vueインスタンスに追加します。これにより、アプリケーション全体でVuexストアが利用可能になります。結構簡単でしょ?
Vuexを使用する際の一般的なディレクトリ構成は以下のようになります。この構成は、プロジェクトの規模や要件に応じて柔軟に変更できます。
src/ store/ index.js state.js mutations.js actions.js getters.js modules/ module1.js module2.js components/ views/ App.vue main.js
この構成では、store ディレクトリ内に Vuex に関連するファイルを配置しています。index.js がメインのストアファイルとなり、state.js、mutations.js、actions.js、getters.js にそれぞれの機能を分離しています。大規模なアプリケーションでは、modules ディレクトリを作成し、機能ごとにストアをモジュール化することもあります。
この構成を採用することで、コードの見通しが良くなり、保守性が向上します。また、チーム開発の際にも、役割分担がしやすくなります。ただし、小規模なプロジェクトでは、すべての機能を index.js にまとめて記述することもあります。プロジェクトの規模や要件に応じて、適切な構成を選択することが大切です。
Vuexを使用したシンプルなカウンターアプリの実装例を見てみましょう。このカウンターアプリでは、ボタンをクリックしてカウントを増減させ、その状態をVuexで管理します。まずは、ストアの設定から始めます。
ストアのindex.jsファイルでは、stateにcountプロパティを定義し、mutationsでincrement、decrementメソッドを作成します。actionsでは、これらのmutationsをコミットするメソッドを定義します。また、現在のカウント値を取得するgetterも作成します。
コンポーネント側では、mapState、mapGetters、mapActionsヘルパーを使用して、ストアの状態やメソッドをコンポーネントにマッピングします。テンプレート部分では、カウント値の表示と、増減ボタンを配置します。このようにして、Vuexを使用したシンプルなカウンターアプリが実装できます。簡単ですよね?
より複雑なアプリケーションでは、Vuexの真価が発揮されます。例えば、ECサイトのショッピングカート機能を考えてみましょう。この場合、商品リスト、カート内の商品、ユーザー情報など、複数の状態を管理する必要があります。
ストア内では、productsモジュール、cartモジュール、userモジュールなど、機能ごとにモジュールを作成します。各モジュールには、それぞれのstate、mutations、actions、gettersを定義します。例えば、cartモジュールには、カートに商品を追加する、削除する、数量を変更するなどのアクションを実装します。
コンポーネント側では、必要な状態やアクションをマッピングして使用します。商品一覧ページでは商品をカートに追加するアクションを、カートページではカート内の商品を操作するアクションを使用します。このように、Vuexを使用することで、複雑なデータフローも整理され、管理しやすくなります。便利でしょ?
Vuexには多くの利点があります。まず、アプリケーションの状態を一元管理できることが大きな特徴です。これにより、データの流れが明確になり、デバッグが容易になります。例えば、Vueの開発者ツールを使用すると、状態の変更履歴を追跡できます。これって、開発効率を大幅に向上させますよね。
次に、コンポーネント間のデータ共有が簡単になります。従来のVueでは、親子関係にないコンポーネント間でデータを共有する場合、複雑なpropsの受け渡しが必要でした。Vuexを使えば、ストアを介して簡単にデータを共有できます。これにより、コードの可読性と保守性が向上します。
さらに、Vuexはプラグインを通じて機能を拡張できます。例えば、ローカルストレージとの同期や、ログ出力などの機能を簡単に追加できます。これにより、アプリケーションの要件に合わせて柔軟にカスタマイズできるんです。
一方で、Vuexにはいくつかの欠点も存在します。まず、小規模なアプリケーションでは過剰な設計になる可能性があります。Vuexの導入には一定の学習コストがかかるため、単純なアプリケーションでは、通常のVueの機能で十分な場合もあります。
また、Vuexを使うと、ボイラープレートコードが増える傾向があります。状態の変更には必ずmutationsを経由する必要があり、これが冗長に感じられることもあります。特に、小さな状態変更の度にactionsやmutationsを定義するのは面倒に感じる人もいるでしょう。
さらに、Vuexは非同期処理の扱いが少し複雑です。actionsを使用して非同期処理を行う必要がありますが、この概念の理解に時間がかかる場合があります。初心者にとっては、この部分が躓きのポイントになることもあるんです。
Vuexは強力なツールですが、すべてのプロジェクトで必要というわけではありません。では、どのような場合にVuexを使うべきなのでしょうか。まず、アプリケーションの規模が大きく、多くのコンポーネントが存在する場合は、Vuexの使用を検討すべきです。
また、複数のビューで同じ状態を参照・更新する必要がある場合も、Vuexが有効です。例えば、ユーザー情報やショッピングカートの内容など、アプリケーション全体で共有される状態がある場合は、Vuexを使用するのが適切です。
さらに、複雑な状態の変更ロジックがある場合も、Vuexを使うことで管理が容易になります。例えば、APIとの通信結果に基づいて複数の状態を更新する必要がある場合などです。Vuexを使えば、このような複雑な処理も整理して実装できるんです。
Vuexのストアが大きくなってくると、すべての状態や操作を1つのファイルで管理するのが困難になってきます。そこで、ストアをモジュール化することが重要です。モジュール化によって、関連する状態や操作をグループ化し、コードの見通しを良くすることができます。
モジュール化の一般的な方法は、機能やドメインごとにモジュールを作成することです。例えば、ユーザー関連の状態を管理する「userモジュール」、商品関連の状態を管理する「productモジュール」などです。各モジュールは、独自のstate、mutations、actions、gettersを持つことができます。
また、大規模なアプリケーションでは、モジュールをさらにサブモジュールに分割することも可能です。この階層構造により、複雑な状態管理も整理して実装できます。ただし、過度に細分化しすぎると、かえって複雑になる可能性があるので、適度なバランスが大切です。
Vuexにおける非同期処理の扱いは、初心者にとってしばしば難しい部分です。基本的に、非同期処理はactionsで行います。actionsは、非同期処理の結果に基づいて、複数のmutationsをコミットすることができます。
非同期処理を実装する際は、Promiseやasync/awaitを活用すると良いでしょう。例えば、APIリクエストを送信し、その結果に基づいて状態を更新する場合、以下のような流れになります:
1. コンポーネントからactionをdispatchする 2. actionでAPIリクエストを送信する 3. リクエストの結果を受け取ったら、mutationをコミットして状態を更新する 4. 更新された状態がコンポーネントに反映される
また、複雑な非同期処理を行う場合は、action内で他のactionをdispatchすることも可能です。こうすることで、処理を小さな単位に分割し、再利用性を高めることができます。
Vuexを使用する際、効果的なデバッグとテストは非常に重要です。まず、Vue Devtoolsを活用することをお勧めします。Vue DevtoolsはVuexと連携しており、状態の変更履歴やTimetravel Debuggingなど、強力なデバッグ機能を提供します。
テストに関しては、Vuexのストアの各部分(state、mutations、actions、getters)を個別にユニットテストすることができます。特に、mutationsは純粋な関数であるため、テストが比較的容易です。actionsのテストでは、モック(模擬)オブジェクトを使用して、外部のAPI呼び出しなどをシミュレートすることができます。
また、Vuexには「厳格モード」(strict mode)があります。このモードを有効にすると、mutationを介さない状態の変更を検出し、警告を発します。開発中はこのモードを有効にし、本番環境では無効にすることで、意図しない状態の変更を防ぐことができます。
ReduxはReact用の状態管理ライブラリですが、VuexとReduxには多くの共通点があります。両者とも単一の真実の源(single source of truth)を持つことを基本としています。しかし、いくつかの重要な違いもあります。
Vuexは、Vue.jsに特化して設計されています。そのため、Vueのリアクティブシステムとシームレスに統合されており、使用感がよりスムーズです。一方、Reduxは、より汎用的で、React以外のフレームワークでも使用できます。
また、Vuexではmutationsとactionsが明確に分離されていますが、Reduxではこれらが一つのreducerという概念にまとめられています。Vuexの方が初心者にとっては理解しやすい構造になっているかもしれません。
MobXは、Observable(観察可能)なデータに基づいた状態管理ライブラリです。VuexとMobXの主な違いは、アプローチの違いにあります。Vuexが明示的で規律的なアプローチを取るのに対し、MobXはより柔軟で自由度の高いアプローチを取ります。
Vuexでは、状態の変更は必ずmutationsを通して行う必要があります。一方、MobXでは、状態を直接変更することができます。これにより、MobXの方がボイラープレートコードが少なくなる傾向があります。
また、VuexがVue.jsに特化しているのに対し、MobXはフレームワーク非依存です。そのため、MobXは様々なJavaScriptフレームワークと組み合わせて使用できます。ただし、Vue.jsとの統合度という点では、VuexがMobXよりも優れています。
Piniaは、Vue.js向けの次世代状態管理ライブラリとして注目を集めています。実際、Vue 3の公式状態管理ライブラリとして採用されました。PiniaはVuexの後継として位置付けられており、Vuexの概念を踏襲しつつ、いくつかの改善が加えられています。
Piniaの大きな特徴は、Vuexのmutations概念がなくなり、actionsで直接状態を変更できるようになったことです。これにより、ボイラープレートコードが減少し、より直感的な使用感が得られます。また、TypeScriptとの親和性も高く、型推論が優れています。
さらに、Piniaではストアの分割がより簡単になりました。Vuexのようにネストされたモジュールを定義する必要がなく、各ストアを独立して定義できます。これにより、コードの見通しが良くなり、保守性が向上します。
ただし、VuexからPiniaへの移行には一定の学習コストがかかります。既存のVuexプロジェクトがある場合、すぐに移行する必要はありませんが、新規プロジェクトではPiniaの使用を検討する価値があるでしょう。Vuexの概念を理解している開発者なら、比較的容易にPiniaに移行できるはずです。
結局のところ、どの状態管理ライブラリを選択するかは、プロジェクトの要件や開発チームの経験、好みによって異なります。Vuexは安定性と豊富な実績があり、大規模なVue.jsプロジェクトで広く使用されています。一方で、PiniaやMobXなどの新しいライブラリは、より簡潔な記述や高いパフォーマンスを提供しています。プロジェクトの特性を考慮し、最適なライブラリを選択することが重要です。
エンジニア、PM、デザイナーの副業・転職採用サービス「Offers(オファーズ)」では、非公開求人を含む豊富なIT・Web業界の転職・副業情報を提供しています。高年収の求人・高時給の案件や最新技術スタックを扱う企業など、あなたのスキルを最大限に活かせるポジションが見つかります。専任のキャリアアドバイザーが、入社日調整や条件交渉をきめ細かくサポート。転職・正社員求人、副業・業務委託案件、募集をお探しの方はOffersまでご相談ください。閉じる
開催前
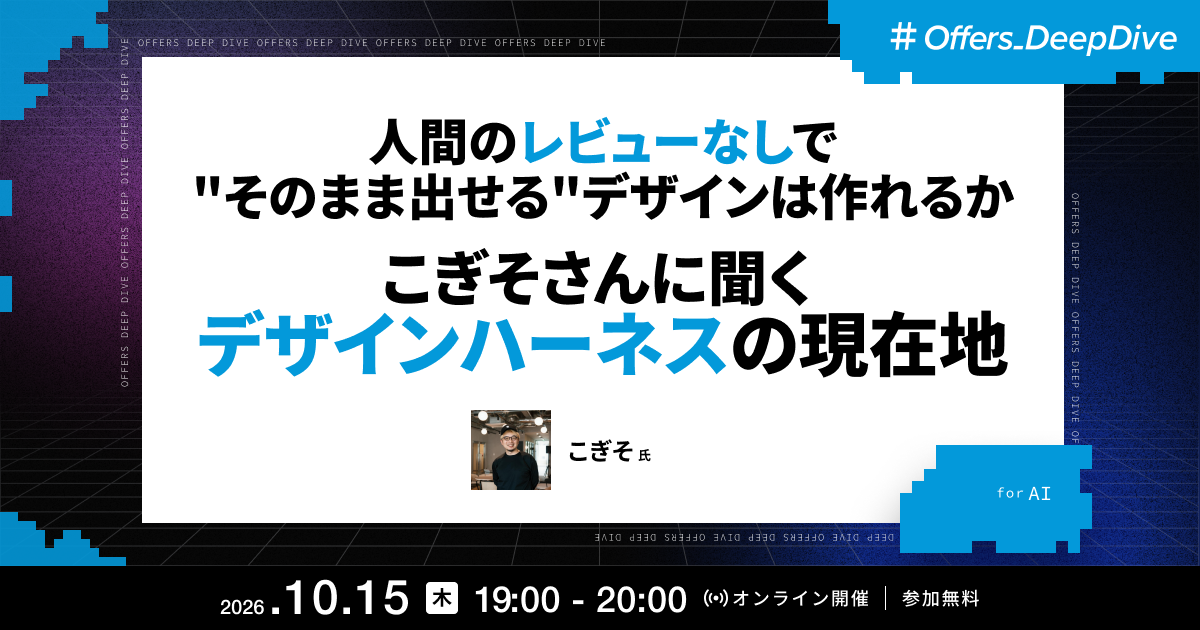
AIコーディングエージェントの進化により、コードだけでなくUIデザインの領域でもAIに任せられる範囲が広がりつつあります。しかし、「AIが出力したデザインを人間のレビューなしでそのまま出せるか?」と問われると、まだ自信を持ってイエスと言える方は少ないのではないでしょうか。 そうした中、AIに「デザイナーの脳内」を型として渡し、デザインの実装だけでなく、評価や改善までを自動化していく「デザインハーネス」という考え方があります。AIにデザインをつくらせて終わりではなく、その出力を評価し、改善するサイクルをできるだけ自律的に回していくことで、AIに任せられる範囲をさらに広げていくアプローチです。しかし、デザインハーネスとは具体的に何を整備すればいいのか、実際にどこまでの品質が出せるのかを体系的に語れる事例はまだ多くありません。そこで本イベントでは、デザインシステムの構築やAIワークフローの実践に豊富な経験を持つこぎそ氏をお迎えし、デザインハーネスの基礎から、具体的な実践事例までを紐解きます。 前半のLTでは、こぎそ氏よりデザインハーネスの基礎的な考え方を整理いただいた上で、Design.mdやMCP連携、デザインシステムとの接続といった実際のワークフローに落とし込んだ実践事例、そして「デザイナーの脳内をどう型化していくか」という方法論をお話しいただきます。 後半のディスカッションでは、AIが出力するデザインの評価軸や、人間が介在すべき領域の見極め、実作業のメイン環境の選び方など、デザインエンジニアの現場目線でさらに深掘りしていきます。 AIを活用したデザインワークフローに関心がある方から、デザインハーネスの導入を検討されている方まで、幅広いデザインエンジニアのご参加をお待ちしています。

開催前
AIコーディングエージェントの進化により、コードを書くスピードはかつてないほど速くなりました。しかし、いくらAIで早くたくさん開発できたとしても、初手の要求・要件定義が十分にできていなければ、結局は使われない機能を量産してしまうのではないでしょうか。 AI時代において、設計や実装の多くはAIに置き換わりつつあります。だからこそ、人間の価値は「問題を定義し、発見する」ことにシフトしていく——そう考えると、要求・要件定義の重要度はこれまで以上に増してきています。しかし、普段の業務で要求・要件定義に本格的に取り組んだ経験がないエンジニアの方も多いのが現状です。 そこで本イベントでは、前回ご好評いただいた「AI時代×ドメイン駆動設計」に続く第2弾として、ミノ駆動氏を再びお迎えし、AI時代だからこそ向き合うべき要求・要件定義の考え方と実践を紐解きます。 前半のLTでは、ミノ駆動氏より、エンジニアに今後求められる「具体→抽象」の思考力、目的を起点とした設計の考え方、そして明日から始められる要求・要件定義の第一歩についてお話しいただきます。 後半のディスカッションでは、「Claude Codeに頼めばよしなにやってくれるのでは?」という率直な疑問から、要求・要件定義は誰が書くべきか、優秀なエンジニアの要求・要件定義は何が違うのかなど、現場目線でさらに深掘りしていきます。 「AIにコードは任せられるようになったけど、その前段階をどうすればいいかわからない」という方にこそ参加いただきたいイベントです。

開催前
AIの進化によってプロダクト開発のハードルが下がった今、企業の関心は「いかに良いものを作るか」から「どうやって市場に届け、ユーザーに使ってもらうか(Go-To-Market)」へとシフトしています。 こうした変化の中で、海外のAIスタートアップを中心に急速に注目を集めているのが「GTM(Go-To-Market)エンジニア」です。 営業でも、マーケターでも、単なる開発エンジニアでもない。 かつて10人のチームで回していた営業・マーケティング・オペレーションの設計からAIによる自動化までを、1人で主導する新たな役割です。 しかし、日本ではまだ認知が広まっておらず、「GTMエンジニアって具体的に何をしているのか」をイメージできている方はほとんどいないのが現状です。 そこで本イベントでは、GTMエンジニアリングの研究・発信を行う中村氏と、GTMエンジニアとして実践されているnumashi氏をお迎えし、海外での動向から日本での実態まで、GTMエンジニアという仕事の全体像を紐解きます。 前半のLTでは、お二人にそれぞれの視点からGTMエンジニアの役割や実際の業務内容、海外と日本での位置づけの違いについてお話しいただきます。 後半のディスカッションでは、どんな方がGTMエンジニアに向いているのか、単なる効率化で終わらせず売上に繋げるには、日本の組織での最初の一歩など、現場目線でさらに深掘りしていきます。 エンジニアとしての新たなキャリアの可能性を探している方から、GTMエンジニアリングに興味がある方まで、幅広いご参加をお待ちしています。

アーカイブ公開中
AIコーディングエージェントの活用が進み、多くの実装や技術選定をAIに委ねられる場面が増えてきました。そうしたなかでも、データベースを扱うORMの選定については「さすがにここだけは自分の手で決めておこう」と考えているエンジニアの方も多いのではないでしょうか。 しかし、従来の選定理由を振り返ってみると、その多くは「型補完がどこまで効くか」「どれだけ直感的にコードが書けるか」といった書き味(DX)や手厚い型サポートにあったのではないでしょうか。AIがコードを書くことが当たり前になった今、「人間にとっての書きやすさ」を軸にした技術選定のあり方には、少しずつ変化が生じ始めています。 では、もし仮にORMの選定すらもAIに任せてみようとしたとき、エンジニアとして最後まで人間が判断しなければいけない業務とは、一体どこにあるのでしょうか。 そこで本イベントでは、Drizzleを活用されているKenn Ejima氏と、Kyselyを使われている溝口(coji)氏をお迎えし、AI時代におけるORM選定の考え方と、「本当に考えなくていいこと」と「実はまだ考えるべきこと」の境界を紐解きます。 前半のLTでは、お二人にそれぞれのORM選定の背景や、AIとの付き合い方を含めた現在の開発スタイルについてお話しいただきます。 後半のディスカッションでは、DBスキーマをAIにどこまで任せるか、マイグレーションの管理、DB選定の重要性など、現場目線でさらに深掘りしていきます。 「ORMは自分が選ぶもの」と自然に思っていた方にこそ、これからの技術選定の軸を一度立ち止まって考えるきっかけになるイベントです。
開催日:
2026年9月9日(水)19:00~20:00

アーカイブ公開中
いま、AIを活用した業務効率化の文脈で「Claude Code」が大きな注目を集めています。しかし、いざ導入しようとすると、セキュリティ面の懸念や権限管理のハードルから、気軽に使えないケースも多いのではないでしょうか。 Coworkは、非エンジニアでも簡単に安全に扱えるよう作られた機能です。そして実は、日常の業務領域であれば「Coworkで十分にカバーできる」だけでなく、想像以上の範囲まで自動化できることは、まだあまり知られていません。 そこで本イベントでは、メルカリで生成AI推進を担当されているハヤカワ五味氏をお迎えし、Coworkを使った業務自動化の実際を、公開デモを交えてわかりやすくお伝えします。 前半のLTでは、ハヤカワ氏よりメルカリでの判断基準をもとに「なぜClaude CodeはNGになりがちで、なぜCoworkなら安全なのか」を解説いただいた上で、Coworkの基本的な機能をご紹介いただきます。 続く公開デモでは、実際にCoworkを使ってワークフローを構築する様子をお見せいただきます。数分でワークフローが完成する手軽さや、Gmail等の外部サービスとセキュアに連携できるポイントなど、実演を通じて具体的なイメージをお届けします。 後半のディスカッションでは、セキュリティの考え方や社内導入の進め方など、現場目線でさらに深掘りしていきます。 「自分の業務をAIで自動化してみたいけど、何から始めればいいかわからない」という方にこそ参加いただきたいイベントです。
開催日:
2026年8月26日(水)19:00~20:00

