
新規ユーザー登録
アカウントを作成して、求人情報のブックマークや応募の管理ができます。
登録特典:
- ・求人情報のブックマーク
- ・高度な求人検索
- ・スカウトメール受信
ApacheSolr
の副業(業務委託)案件・求人情報
1~0件(0件)
アカウントを作成して、求人情報のブックマークや応募の管理ができます。
求人に関するサマリ
Apache Solrは、高性能な全文検索エンジンとして広く知られているオープンソースのソフトウェアです。企業や組織が大量のデータを効率的に検索・分析するために開発されました。Apache Solrは、Webサイト、データベース、ドキュメントなど、様々なソースからのテキストデータを扱うことができます。その柔軟性と拡張性から、多くの開発者や企業に支持されているんです。
Apache Solrの特徴として、高速な検索処理、スケーラビリティ、そして豊富な機能が挙げられます。例えば、ファセット検索、ハイライト機能、地理空間検索など、多彩な検索オプションを提供しているんですよ。また、RESTful APIを通じて簡単に操作できるため、既存のシステムとの統合も容易です。
Apache Solrは、Java言語で書かれており、Apache Software Foundationによって管理されています。2004年にCREEによって開発が始まり、2006年にApache Luceneのサブプロジェクトとなりました。その後、2010年にApache Luceneから独立したトップレベルプロジェクトとなり、現在に至っています。
Apache SolrとApache Luceneは、密接な関係にあります。実際、Apache SolrはApache Luceneを基盤として構築されているんです。Apache Luceneは、高性能な全文検索ライブラリで、Apache Solrはこれをベースに、より使いやすく、機能豊富な検索プラットフォームを提供しています。
Apache Luceneが提供する基本的な検索機能に加えて、Apache Solrは分散検索、キャッシュ機能、管理インターフェースなどの追加機能を備えています。つまり、Apache SolrはApache Luceneの機能を拡張し、より実用的で使いやすいものにしているわけです。
両者の関係を簡単に例えると、Apache Luceneがエンジンであるのに対し、Apache Solrは完成した車のようなものだと言えるでしょう。Apache Solrを使用することで、開発者はApache Luceneの高度な検索機能を、より簡単に、そして効率的に利用できるんです。
Apache Solrの中核となる機能が、全文検索です。この機能により、大量のテキストデータから、ユーザーが求める情報を素早く、正確に見つけ出すことができます。全文検索は、単純なキーワードマッチングだけでなく、自然言語処理や形態素解析などの高度な技術を駆使して実現されています。
例えば、Apache Solrは検索クエリの解析、ステミング(語幹抽出)、同義語展開などの処理を行い、より正確な検索結果を提供します。また、ファジー検索や近接検索など、柔軟な検索オプションも備えているんですよ。これにより、ユーザーのニーズに合わせた検索体験を実現できるんです。
さらに、Apache Solrの全文検索機能は、多言語対応も特徴の一つです。日本語はもちろん、英語、中国語、アラビア語など、様々な言語のテキストを適切に処理し、検索することができます。この多言語対応により、グローバルな環境での利用も可能となっているんです。
Apache Solrのもう一つの重要な機能が、リアルタイムインデックス作成です。この機能により、新しいデータが追加されたり、既存のデータが更新されたりした際に、即座にインデックスに反映することができます。つまり、常に最新の情報を検索結果に含めることができるんです。
従来の検索エンジンでは、インデックスの更新に時間がかかり、最新の情報が検索結果に反映されるまでにタイムラグが生じることがありました。しかし、Apache Solrのリアルタイムインデックス作成機能を使えば、そのような問題を解決できるんです。例えば、ニュースサイトやEコマースサイトなど、常に最新の情報を提供する必要があるウェブサイトで特に重要な機能となっています。
また、この機能は大量のデータを扱う場合でも効率的に動作します。Apache Solrは、新しいデータを受け取ると、まずメモリ上のインデックスに追加し、その後ディスク上のインデックスに反映させます。これにより、高速なインデックス更新と安定した検索パフォーマンスを両立しているんですよ。
Apache Solrは、大規模なデータセットを効率的に処理するために、クラスタリング機能を提供しています。この機能を使うことで、複数のSolrサーバーを連携させ、分散処理を実現できるんです。クラスタリングにより、検索処理の負荷を分散させ、システム全体のパフォーマンスと可用性を向上させることができます。
特に注目すべきは、SolrCloudと呼ばれる機能です。SolrCloudは、Apache Solrの分散処理機能をさらに強化したもので、自動的にインデックスのシャーディング(分割)とレプリケーション(複製)を行います。これにより、大規模なデータセットでも高可用性と耐障害性を確保できるんです。
例えば、1台のサーバーがダウンしても、他のサーバーが自動的にその役割を引き継ぐので、システム全体の可用性が保たれます。また、データ量が増加した場合も、新しいサーバーを追加するだけで簡単にスケールアウトできるんですよ。このような特徴から、SolrCloudは大規模なウェブサイトや企業システムで広く採用されています。
Apache Solrの大きな強みの一つが、豊富で柔軟な検索オプションです。単純なキーワード検索だけでなく、様々な条件を組み合わせた高度な検索が可能なんです。例えば、ファセット検索、地理空間検索、ハイライト機能など、多彩な検索オプションを提供しています。
ファセット検索は、検索結果をカテゴリーや属性ごとに分類して表示する機能です。これにより、ユーザーは検索結果を絞り込んだり、全体像を把握したりすることができます。例えば、ECサイトでの商品検索時に、ブランドや価格帯、色などでフィルタリングできるのは、このファセット検索の機能によるものなんですよ。
地理空間検索も、Apache Solrの特徴的な機能の一つです。緯度経度情報を使って、特定の地点からの距離や特定の地域内にある情報を検索することができます。例えば、「現在地から5キロメートル以内のレストラン」といった検索が可能になるんです。これは、位置情報を活用したサービスやアプリケーションの開発に非常に有用です。
Apache Solrの魅力的な特徴の一つが、プラグインによる高い拡張性です。標準の機能だけでなく、ユーザーのニーズに合わせて機能を追加したり、カスタマイズしたりすることができるんです。これにより、Apache Solrを様々な用途や環境に適応させることが可能になります。
例えば、日本語の形態素解析エンジンであるKuromojiを導入することで、日本語テキストの高精度な解析と検索が可能になります。また、同義語辞書や専門用語辞書などのプラグインを追加することで、特定の分野や業界に特化した検索システムを構築することもできるんですよ。
さらに、独自のプラグインを開発することも可能です。Apache SolrはJavaで書かれているため、Javaの知識があれば、自分たちの要求に合わせたカスタムプラグインを作成できます。この拡張性により、Apache Solrは様々な業界や分野で幅広く活用されているんです。
Apache Solrには多くの利点があります。まず、高速な検索処理能力が挙げられます。大量のデータを扱う場合でも、迅速に検索結果を返すことができるんです。例えば、Amazonのような大規模なECサイトでも、Apache Solrを使用することで、数百万件の商品データから瞬時に検索結果を表示することが可能です。
次に、スケーラビリティの高さも大きな利点です。SolrCloudを使用することで、データ量の増加に応じて簡単にシステムを拡張できます。これにより、小規模なプロジェクトから大規模な企業システムまで、幅広い規模のプロジェクトに対応できるんですよ。
また、豊富な機能と柔軟なカスタマイズ性も魅力的です。標準で多くの機能を提供しているだけでなく、プラグインによる拡張も可能なため、様々なニーズに対応できます。さらに、オープンソースソフトウェアであるため、コストを抑えつつ高機能な検索システムを構築できるという利点もあります。
一方で、Apache Solrにはいくつかのデメリットも存在します。まず、セットアップと設定の複雑さが挙げられます。Apache Solrは非常に柔軟で強力なツールですが、その分、適切に設定するには専門知識が必要となります。特に初心者にとっては、学習曲線が急な場合があるんです。
また、メモリ使用量が多いという点も注意が必要です。Apache Solrは高速な検索を実現するために、インデックスの一部をメモリ上に保持します。これにより、大規模なデータセットを扱う場合、相当量のメモリが必要となる可能性があります。例えば、1,000万件のドキュメントを扱う場合、数十ギガバイトのメモリが必要になることもあるんですよ。
さらに、リアルタイム性に関する制限も挙げられます。Apache Solrはリアルタイムインデックス作成機能を持っていますが、完全なリアルタイム検索には向いていません。更新頻度が非常に高いデータを扱う場合、他のソリューションを検討する必要があるかもしれません。これらのデメリットを理解し、適切に対処することが、Apache Solrを効果的に活用するポイントとなります。
Apache Solrは、英語圏の多くの大手企業や組織で採用されています。例えば、世界最大のEコマースプラットフォームの一つであるeBayでは、Apache Solrを使用して商品検索機能を実現しています。eBayの場合、数億件に及ぶ商品データの中から、ユーザーが求める商品を瞬時に見つけ出すことができるんです。
また、ニュースや情報サイトでもApache Solrが活用されています。例えば、The Guardianというイギリスの新聞社は、Apache Solrを使って記事の検索機能を提供しています。数十年分の記事アーカイブから、関連性の高い記事を素早く見つけ出すことができるんですよ。
さらに、学術分野でもApache Solrの利用が進んでいます。スタンフォード大学図書館では、Apache Solrを使って膨大な量の学術論文や書籍を検索可能にしています。これにより、研究者や学生が必要な情報を効率的に見つけられるようになっているんです。これらの事例は、Apache Solrが様々な分野で高い評価を得ていることを示しています。
日本国内でも、Apache Solrの導入事例は増加しています。例えば、大手ECサイトの楽天市場では、Apache Solrを使用して商品検索機能を実現しています。楽天市場では、数億点に及ぶ商品データの中から、ユーザーが求める商品を瞬時に見つけ出すことができるんです。この高速な検索機能により、ユーザー体験の向上と売上の増加につながっているんですよ。
また、国内最大級の求人情報サイトであるIndeedでも、Apache Solrが採用されています。膨大な求人情報の中から、職種、勤務地、給与などの条件に合致する求人を素早く検索できる機能を実現しているんです。これにより、求職者は効率的に希望の求人を見つけることができます。
さらに、国立国会図書館でもApache Solrが使用されています。約4,000万件に及ぶ蔵書データを検索可能にしているんです。研究者や一般利用者が、膨大な蔵書の中から必要な資料を迅速に見つけられるようになっています。これらの事例は、Apache Solrが日本国内でも幅広い分野で活用されていることを示しています。
Apache Solrの性能を最大限に引き出すためには、適切な基本設定が不可欠です。まず重要なのが、JVMの設定です。適切なヒープサイズを設定することで、メモリ不足によるパフォーマンス低下を防ぐことができます。一般的には、利用可能な物理メモリの50%程度をヒープサイズとして設定することが推奨されています。
次に、インデックスの設定も重要です。フィールドタイプの適切な選択や、インデックス作成時のオプション設定により、検索性能を大幅に向上させることができます。例えば、テキストフィールドに対してはテキスト解析を行い、数値フィールドには適切な精度を設定するなどの工夫が必要です。
また、キャッシュの設定も忘れてはいけません。Apache Solrには、フィルターキャッシュ、クエリ結果キャッシュ、ドキュメントキャッシュなど、複数のキャッシュ機能があります。これらを適切に設定することで、頻繁に実行される検索の応答時間を大幅に短縮できるんです。
Apache Solrのパフォーマンスをさらに向上させるためには、より高度な最適化が必要です。まず、クエリの最適化が重要です。複雑なクエリや頻繁に実行されるクエリを分析し、インデックス設計やフィルターの使用方法を見直すことで、検索速度を大幅に改善できます。
次に、インデックスの最適化も効果的です。定期的にインデックスの最適化を行うことで、断片化を減らし、検索性能を向上させることができます。ただし、大規模なインデックスの場合、最適化には時間がかかる場合があるので、運用時間外に実行するなどの工夫が必要です。
また、ハードウェアの最適化も重要です。SSDの使用やRAIDの適切な設定により、ディスクI/Oのボトルネックを解消できます。例えば、Amazon Web Servicesを利用している場合、EBSのIOPSを増やすことで、大幅なパフォーマンス向上が期待できるんですよ。これらの最適化を適切に行うことで、Apache Solrの性能を最大限に引き出すことができます。
Apache Solrのスケーラビリティを向上させるには、いくつかの重要な戦略があります。まず、シャーディングの活用が挙げられます。データを複数のシャードに分割することで、検索処理を並列化し、全体的なパフォーマンスを向上させることができます。例えば、1億件のドキュメントを10個のシャードに分割すれば、各シャードは1,000万件のドキュメントのみを処理すればよくなるんです。
次に、レプリケーションの適切な設定も重要です。レプリカを増やすことで、読み取り性能と可用性を向上させることができます。ただし、レプリカを増やすとそれだけリソースも必要になるので、コストとのバランスを考慮する必要があります。一般的には、重要なデータに対して2〜3個のレプリカを設定することが多いですね。
また、負荷分散の適切な設定も忘れてはいけません。HAProxyやNginxなどのロードバランサーを使用して、複数のSolrノードに均等にリクエストを分散させることで、システム全体の性能と安定性を向上させることができます。これらの戦略を組み合わせることで、Apache Solrの優れたスケーラビリティを最大限に活用できるんです。
Apache Solrで日本語テキストを効果的に扱うには、Kuromojiという形態素解析エンジンの導入が欠かせません。Kuromojiは、日本語テキストを適切に分かち書きし、検索に最適な形に処理してくれるんです。例えば、「東京スカイツリーに行きました」という文章を、「東京」「スカイツリー」「行く」のように分解してくれます。
Kuromojiの導入は比較的簡単です。まず、Kuromojiのjarファイルをsolr/libディレクトリに配置します。次に、schema.xmlファイルで日本語用のフィールドタイプを定義します。この際、tokenizer(トークナイザー)としてjapaneseTokenizerを指定し、必要に応じてfilter(フィルター)を追加します。
設定が完了すれば、日本語テキストの高精度な解析と検索が可能になります。例えば、「食べる」で検索すると、「食べました」「食べている」などの活用形も含めてヒットするようになるんです。Kuromojiの導入により、日本語サイトやアプリケーションでのApache Solrの活用範囲が大きく広がります。
Apache Solrはメールサーバとの連携も可能で、大量のメールデータを効率的に検索できるようになります。例えば、Gmailのような大規模なメールサービスでも、Apache Solrを使用することで、数十億通のメールの中から瞬時に目的のメールを見つけ出すことができるんです。
連携の方法としては、まずメールサーバからメールデータをエクスポートし、Apache Solrにインデックスとして取り込みます。この際、メールの件名、本文、送信者、受信日時などの情報をそれぞれ適切なフィールドにマッピングします。データの取り込みには、Apache Solrが提供するData Import Handlerを使用すると便利です。
設定が完了すれば、高度なメール検索が可能になります。例えば、「先月中に田中さんから受け取った添付ファイル付きのメール」といった複雑な条件での検索も瞬時に実行できるようになるんです。これにより、ビジネスユーザーの生産性向上に大きく貢献できます。
Apache SolrCloud環境では、Apache Zookeeperが重要な役割を果たします。Zookeeperは、分散システムの調整を行うサービスで、SolrCloudの設定情報の管理やクラスタの状態監視を担当します。例えば、どのSolrノードがどのシャードを担当しているかという情報をZookeeperが管理しているんです。
Zookeeperの導入は比較的簡単です。Solrのインストールパッケージにはすでにzookeeper.jarが含まれているので、追加のダウンロードは不要です。設定ファイル(zoo.cfg)を適切に編集し、Zookeeperサービスを起動するだけで使用できます。
Zookeeperを使用することで、SolrCloudの管理が格段に楽になります。例えば、新しいSolrノードを追加する際も、Zookeeperが自動的に新ノードを認識し、適切なシャードを割り当ててくれます。また、ノードの障害時も、Zookeeperがそれを検知し、他のノードに処理を振り分けることで、システム全体の可用性を保つことができるんです。
Apache Solrのインストールは、比較的簡単な手順で行うことができます。まず、Apache Solrの公式サイトから最新のバージョンをダウンロードします。2024年7月現在、最新の安定版は9.5.0です。ダウンロードしたパッケージを解凍し、任意のディレクトリに配置します。
次に、Javaがインストールされていることを確認します。Apache Solrは、Java 11以降のバージョンを必要とします。Java Development Kit(JDK)がインストールされていない場合は、先にインストールしておく必要があります。
インストールが完了したら、コマンドラインから「bin/solr start」コマンドを実行することで、Solrを起動できます。デフォルトでは、http://localhost:8983/solr にアクセスすることで、Solrの管理画面を表示できます。この画面から、コアの作成やスキーマの設定、インデックスの管理などを行うことができるんです。
Apache Solrのセットアップ後には、いくつかの重要な確認事項があります。まず、Solrが正常に起動していることを確認します。管理画面にアクセスし、ダッシュボードが正しく表示されることを確認してください。
次に、テストコアを作成し、サンプルドキュメントをインデックスしてみましょう。これにより、インデックス作成と検索が正常に機能することを確認できます。例えば、「bin/solr create -c techproducts」コマンドでテストコアを作成し、サンプルデータをインデックスすることができます。
また、セキュリティ設定も重要です。デフォルトでは認証が無効になっているので、必要に応じて認証を有効にし、適切なアクセス制御を設定してください。さらに、JVMのメモリ設定やログの出力先なども確認し、必要に応じて調整することをおすすめします。これらの確認を行うことで、安全で効率的なApache Solrの運用が可能になります。
Apache Solrを実装する際には、いくつかの重要な注意点があります。まず、スキーマ設計には十分な時間をかけることが大切です。適切なフィールドタイプの選択や、インデックス作成オプションの設定により、検索性能が大きく変わってくるんです。例えば、テキストフィールドに対しては適切なアナライザーを選択し、数値フィールドには適切な精度を設定するなどの工夫が必要です。
次に、パフォーマンスチューニングにも注意が必要です。大量のデータを扱う場合、インデックス作成や検索のパフォーマンスが低下する可能性があります。こまめにパフォーマンスをモニタリングし、必要に応じてキャッシュ設定の調整やクエリの最適化を行うことが重要です。
また、バックアップと復旧の計画も忘れてはいけません。定期的にインデックスのバックアップを取り、障害時に迅速に復旧できるよう準備しておくことが大切です。さらに、セキュリティにも十分な注意を払い、適切なアクセス制御や暗号化を実装することをおすすめします。これらの点に注意を払うことで、安定的で効率的なApache Solrの運用が可能になるんです。
Apache Solrを運用していると、いくつかの典型的な問題に遭遇することがあります。まず、メモリ不足による問題が挙げられます。大量のデータをインデックス化する際や、複雑なクエリを実行する際に発生しやすいんです。この問題は、JVMのヒープサイズを適切に設定することで解決できます。例えば、「-Xms4g -Xmx8g」のようにJVMオプションを設定し、最小4GB、最大8GBのヒープを割り当てるといった具合です。
次によく見られるのが、インデックス作成の遅延です。大量のドキュメントを一度にインデックス化しようとすると、処理に時間がかかることがあります。この場合、バッチサイズを調整したり、並列処理を活用したりすることで改善できます。例えば、commitWithin パラメータを使用して、一定間隔でコミットを強制することも効果的です。
また、検索結果の精度に関する問題も頻繁に発生します。これは多くの場合、スキーマ設定やアナライザーの選択が適切でないことが原因です。例えば、日本語テキストを扱う場合、Kuromojiアナライザーを使用し、適切な設定を行うことで大幅に改善できることがあります。これらの一般的な問題に対処することで、Apache Solrの安定した運用が可能になります。
Apache Solrでトラブルが発生した際の対処法について、いくつか重要なポイントがあります。まず、ログの確認が非常に重要です。Solrは詳細なログを出力するので、エラーメッセージやスタックトレースを注意深く読むことで、問題の原因を特定できることが多いんです。デフォルトでは、ログファイルはserver/logs/ディレクトリに保存されています。
次に、Solrの管理画面を活用することも効果的です。管理画面では、各コアの状態やシステムの情報を確認できます。例えば、特定のコアでインデックス作成や検索に問題が発生している場合、そのコアの詳細情報を確認することで、原因を突き止めやすくなります。
また、問題の再現と切り分けも重要です。できるだけシンプルな環境で問題を再現し、一つずつ条件を変えながら原因を特定していくアプローチが効果的です。例えば、特定のクエリで問題が発生する場合、クエリを単純化していき、どの部分で問題が発生するかを特定していくんです。これらの方法を組み合わせることで、多くのトラブルを効率的に解決できます。トラブルシューティングのスキルを磨くことで、Apache Solrの運用がより安定したものになるでしょう。
Apache Solrは非常に強力で柔軟な全文検索エンジンです。その高度な機能と拡張性により、様々な規模や種類のプロジェクトで活用されています。しかし、その力を最大限に引き出すためには、適切な設定と運用が不可欠です。本記事で紹介した基本的な概念や設定方法、トラブルシューティングの手法を参考に、自身のプロジェクトに最適なApache Solrの環境を構築してみてください。適切に設定されたApache Solrは、ユーザー体験を大幅に向上させ、ビジネスの成功に大きく貢献するはずです。
Apache Solrの世界は深く、常に進化を続けています。新しいバージョンがリリースされるたびに、さらなる機能や改善が加えられているんです。そのため、公式ドキュメントや関連コミュニティの情報を定期的にチェックし、最新の動向をフォローすることをおすすめします。また、実際に手を動かして実験してみることも、理解を深める上で非常に効果的です。Apache Solrの可能性を探求し、自身のプロジェクトで最大限に活用してください。きっと、データ駆動型の意思決定や、ユーザー体験の向上に大きく貢献するはずです。
エンジニア、PM、デザイナーの副業・転職採用サービス「Offers(オファーズ)」では、非公開求人を含む豊富なIT・Web業界の転職・副業情報を提供しています。高年収の求人・高時給の案件や最新技術スタックを扱う企業など、あなたのスキルを最大限に活かせるポジションが見つかります。専任のキャリアアドバイザーが、入社日調整や条件交渉をきめ細かくサポート。転職・正社員求人、副業・業務委託案件、募集をお探しの方はOffersまでご相談ください。閉じる
開催前
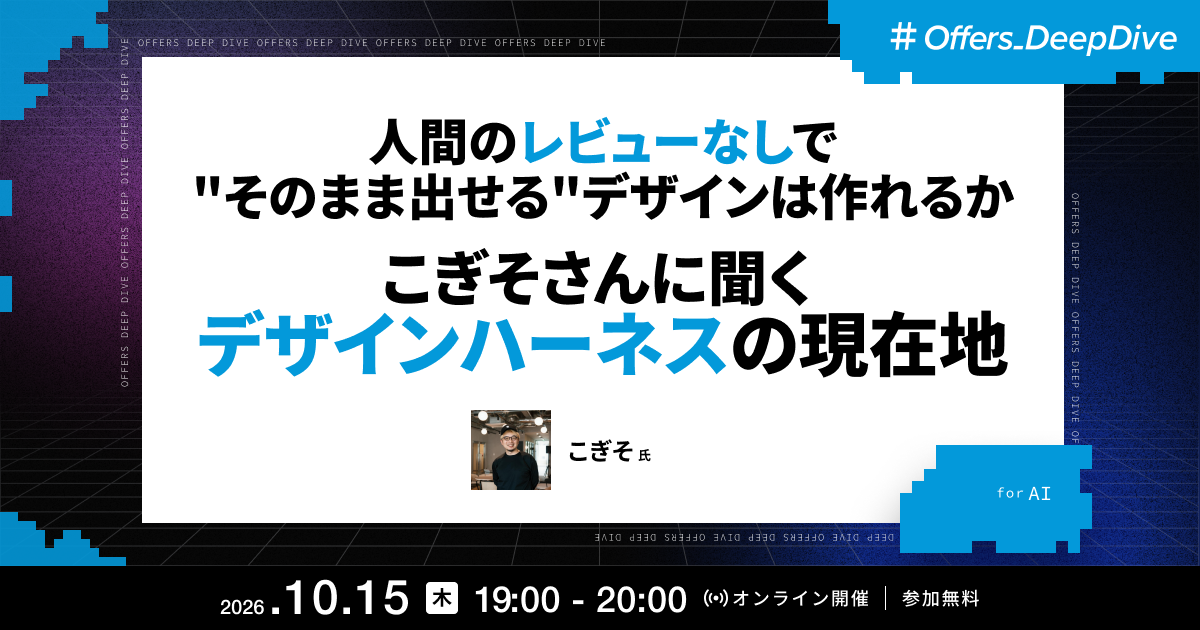
AIコーディングエージェントの進化により、コードだけでなくUIデザインの領域でもAIに任せられる範囲が広がりつつあります。しかし、「AIが出力したデザインを人間のレビューなしでそのまま出せるか?」と問われると、まだ自信を持ってイエスと言える方は少ないのではないでしょうか。 そうした中、AIに「デザイナーの脳内」を型として渡し、デザインの実装だけでなく、評価や改善までを自動化していく「デザインハーネス」という考え方があります。AIにデザインをつくらせて終わりではなく、その出力を評価し、改善するサイクルをできるだけ自律的に回していくことで、AIに任せられる範囲をさらに広げていくアプローチです。しかし、デザインハーネスとは具体的に何を整備すればいいのか、実際にどこまでの品質が出せるのかを体系的に語れる事例はまだ多くありません。そこで本イベントでは、デザインシステムの構築やAIワークフローの実践に豊富な経験を持つこぎそ氏をお迎えし、デザインハーネスの基礎から、具体的な実践事例までを紐解きます。 前半のLTでは、こぎそ氏よりデザインハーネスの基礎的な考え方を整理いただいた上で、Design.mdやMCP連携、デザインシステムとの接続といった実際のワークフローに落とし込んだ実践事例、そして「デザイナーの脳内をどう型化していくか」という方法論をお話しいただきます。 後半のディスカッションでは、AIが出力するデザインの評価軸や、人間が介在すべき領域の見極め、実作業のメイン環境の選び方など、デザインエンジニアの現場目線でさらに深掘りしていきます。 AIを活用したデザインワークフローに関心がある方から、デザインハーネスの導入を検討されている方まで、幅広いデザインエンジニアのご参加をお待ちしています。

開催前
AIコーディングエージェントの進化により、コードを書くスピードはかつてないほど速くなりました。しかし、いくらAIで早くたくさん開発できたとしても、初手の要求・要件定義が十分にできていなければ、結局は使われない機能を量産してしまうのではないでしょうか。 AI時代において、設計や実装の多くはAIに置き換わりつつあります。だからこそ、人間の価値は「問題を定義し、発見する」ことにシフトしていく——そう考えると、要求・要件定義の重要度はこれまで以上に増してきています。しかし、普段の業務で要求・要件定義に本格的に取り組んだ経験がないエンジニアの方も多いのが現状です。 そこで本イベントでは、前回ご好評いただいた「AI時代×ドメイン駆動設計」に続く第2弾として、ミノ駆動氏を再びお迎えし、AI時代だからこそ向き合うべき要求・要件定義の考え方と実践を紐解きます。 前半のLTでは、ミノ駆動氏より、エンジニアに今後求められる「具体→抽象」の思考力、目的を起点とした設計の考え方、そして明日から始められる要求・要件定義の第一歩についてお話しいただきます。 後半のディスカッションでは、「Claude Codeに頼めばよしなにやってくれるのでは?」という率直な疑問から、要求・要件定義は誰が書くべきか、優秀なエンジニアの要求・要件定義は何が違うのかなど、現場目線でさらに深掘りしていきます。 「AIにコードは任せられるようになったけど、その前段階をどうすればいいかわからない」という方にこそ参加いただきたいイベントです。

開催前
AIの進化によってプロダクト開発のハードルが下がった今、企業の関心は「いかに良いものを作るか」から「どうやって市場に届け、ユーザーに使ってもらうか(Go-To-Market)」へとシフトしています。 こうした変化の中で、海外のAIスタートアップを中心に急速に注目を集めているのが「GTM(Go-To-Market)エンジニア」です。 営業でも、マーケターでも、単なる開発エンジニアでもない。 かつて10人のチームで回していた営業・マーケティング・オペレーションの設計からAIによる自動化までを、1人で主導する新たな役割です。 しかし、日本ではまだ認知が広まっておらず、「GTMエンジニアって具体的に何をしているのか」をイメージできている方はほとんどいないのが現状です。 そこで本イベントでは、GTMエンジニアリングの研究・発信を行う中村氏と、GTMエンジニアとして実践されているnumashi氏をお迎えし、海外での動向から日本での実態まで、GTMエンジニアという仕事の全体像を紐解きます。 前半のLTでは、お二人にそれぞれの視点からGTMエンジニアの役割や実際の業務内容、海外と日本での位置づけの違いについてお話しいただきます。 後半のディスカッションでは、どんな方がGTMエンジニアに向いているのか、単なる効率化で終わらせず売上に繋げるには、日本の組織での最初の一歩など、現場目線でさらに深掘りしていきます。 エンジニアとしての新たなキャリアの可能性を探している方から、GTMエンジニアリングに興味がある方まで、幅広いご参加をお待ちしています。

アーカイブ公開中
AIコーディングエージェントの活用が進み、多くの実装や技術選定をAIに委ねられる場面が増えてきました。そうしたなかでも、データベースを扱うORMの選定については「さすがにここだけは自分の手で決めておこう」と考えているエンジニアの方も多いのではないでしょうか。 しかし、従来の選定理由を振り返ってみると、その多くは「型補完がどこまで効くか」「どれだけ直感的にコードが書けるか」といった書き味(DX)や手厚い型サポートにあったのではないでしょうか。AIがコードを書くことが当たり前になった今、「人間にとっての書きやすさ」を軸にした技術選定のあり方には、少しずつ変化が生じ始めています。 では、もし仮にORMの選定すらもAIに任せてみようとしたとき、エンジニアとして最後まで人間が判断しなければいけない業務とは、一体どこにあるのでしょうか。 そこで本イベントでは、Drizzleを活用されているKenn Ejima氏と、Kyselyを使われている溝口(coji)氏をお迎えし、AI時代におけるORM選定の考え方と、「本当に考えなくていいこと」と「実はまだ考えるべきこと」の境界を紐解きます。 前半のLTでは、お二人にそれぞれのORM選定の背景や、AIとの付き合い方を含めた現在の開発スタイルについてお話しいただきます。 後半のディスカッションでは、DBスキーマをAIにどこまで任せるか、マイグレーションの管理、DB選定の重要性など、現場目線でさらに深掘りしていきます。 「ORMは自分が選ぶもの」と自然に思っていた方にこそ、これからの技術選定の軸を一度立ち止まって考えるきっかけになるイベントです。
開催日:
2026年9月9日(水)19:00~20:00

アーカイブ公開中
いま、AIを活用した業務効率化の文脈で「Claude Code」が大きな注目を集めています。しかし、いざ導入しようとすると、セキュリティ面の懸念や権限管理のハードルから、気軽に使えないケースも多いのではないでしょうか。 Coworkは、非エンジニアでも簡単に安全に扱えるよう作られた機能です。そして実は、日常の業務領域であれば「Coworkで十分にカバーできる」だけでなく、想像以上の範囲まで自動化できることは、まだあまり知られていません。 そこで本イベントでは、メルカリで生成AI推進を担当されているハヤカワ五味氏をお迎えし、Coworkを使った業務自動化の実際を、公開デモを交えてわかりやすくお伝えします。 前半のLTでは、ハヤカワ氏よりメルカリでの判断基準をもとに「なぜClaude CodeはNGになりがちで、なぜCoworkなら安全なのか」を解説いただいた上で、Coworkの基本的な機能をご紹介いただきます。 続く公開デモでは、実際にCoworkを使ってワークフローを構築する様子をお見せいただきます。数分でワークフローが完成する手軽さや、Gmail等の外部サービスとセキュアに連携できるポイントなど、実演を通じて具体的なイメージをお届けします。 後半のディスカッションでは、セキュリティの考え方や社内導入の進め方など、現場目線でさらに深掘りしていきます。 「自分の業務をAIで自動化してみたいけど、何から始めればいいかわからない」という方にこそ参加いただきたいイベントです。
開催日:
2026年8月26日(水)19:00~20:00