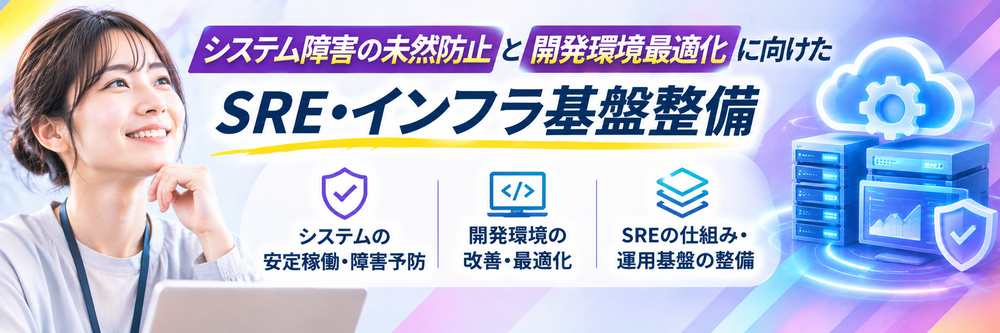

⚪︎ システム障害の未然防止と信頼性向上: 障害発生後の対応にとどまらず、システムの稼働状況や潜在的なリスクを把握し、障害を予防するための仕組みづくりが求められています。
⚪︎ 監視・可観測性の強化: New RelicやZabbixなどの監視ツールを活用し、システムの状態を適切に可視化するとともに、SLI/SLOの設計・導入を通じてサービスの信頼性を継続的に評価・改善できる環境を整える必要があります。
⚪︎ アラート運用の最適化: 重複アラートの削減や監視設定の見直しを進め、重要な異常を適切に検知できる仕組みを整備することで、障害対応の効率化を図ることが重要です。
⚪︎ インフラ管理のコード化・自動化: TerraformやAnsibleなどのIaC技術を活用し、インフラ構成の管理や運用作業を効率化することで、作業負荷の軽減と運用品質の向上を目指しています。
⚪︎ インフラ基盤のパフォーマンス最適化: AWS Gravitonへの移行やミドルウェア設定の見直しなどを通じて、システムの性能やリソース効率を改善することが求められています。
⚪︎ 障害対応プロセスの標準化: 障害発生時の対応手順や運用プロセスを整理し、関係者が円滑に対応できる体制を整備することが重要です。
⚪︎ 開発チームの生産性向上: インフラに関する問い合わせ対応や技術支援、ドキュメント整備を通じて、開発エンジニアが本来の開発業務に集中できる環境づくりが求められています。