Connpassの詳細はこちらから
資料はこちらから
[fujiwara氏✖️そーだい氏]実例をもとにしたWebパフォーマンスチューニングの読み解き方
公開 更新
f
登壇者面白法人カヤック SREチーム
fujiwara2011年より面白法人カヤック。SREチームリーダー。主にソーシャルゲーム、自社サービスを担当。 ISUCON優勝4回、出題3回。最近の趣味はマネージドサービスの隙間を埋める隙間家具のようなツールをGoで作ってOSSにすること、ランニング。
曽
登壇者合同会社 Have Fun Tech代表社員兼、株式会社 Linkage CTO
曽根 壮大合同会社 Have Fun Tech 代表社員、株式会社 Linkage CTO。数々の業務システム、Webサービスなどの開発・運用を担当し、2017年に株式会社はてなでサービス監視サービス「Mackerel」のCRE(Customer Reliability Engineer)、株式会社オミカレの副社長/CTOなどを経て、合同会社 Have Fun Techを起業。 その後、LinkageのCTOとしてJOINし、HaveFunTechの経営と二足の草鞋を履きこなしている。 コミュニティでは、Microsoft MVPをはじめ、日本PostgreSQLユーザ会の理事として勉強会の開催を担当し、各地で登壇している。 builderscon 2017、YAPC::Kansaiなどのイベントでベストスピーカーを受賞し、分かりやすく実践的な内容のトークに定評がある。 他に、岡山Python勉強会を主催し、オープンラボ備後にも所属。著書に『Software Design』誌で、データベースに関する連載「RDBアンチパターン」をまとめた『失敗から学ぶRDBの正しい歩き方』を執筆。
大
登壇者プロダクト開発・技術顧問
大西 政徳新卒でゲーム系スタートアップに入社。ゲーム開発において、開発・保守・運用を一通り経験。2018年4月より株式会社LegalForceに二人目のエンジニアとして入社。MVP立ち上げ、LegalForceの製品版開発・運用、DDDを用いた開発改善活動・推進を行う。2021年10月よりスタートアップ連携管理SaaSを開発するInnoScouterにCTOとして参画。プロダクト開発の指揮統括、開発組織の体制構築を行う。2021年末に株式会社01BoosterにM&A。2024年6月より独立。プロダクト開発、技術顧問業などを行う。
[webパフォーマンスチューニング事例]負荷試験はクリアしたものの、本番で障害が起きたケース
このプロジェクトでは、リリース前に負荷試験をしていて、rps(requests per sconds)は2500を想定していました。試験時はその想定をクリアできたものの、本番では障害が起きてしまったという事例です。
このケースで、負荷試験の時点で「ボトルネックだ」と認識していたクエリがこちらです。

このクエリが問題なのはわかっていました。このORDER BYのとこに「isXXX」という値があります。上のSELECTのカラムに書いていますが、この「l.is_xxx」の値と、「h.id IS NOT NULL」を演算した値でORDER BYしています。これの何が問題かというと、indexを使えなくなってしまいます。
そのためテーブルをフルスキャンすることになりますが、100行しかスキャンする必要がないところを2000行程度をスキャンする計画になっていました。これはよくないので、直すという選択肢もありましたが、タイトなスケジュールだったことと、この程度は致命的ではないとの判断から、そのままリリースしたんです。すると障害が起きてしまったと。
[webパフォーマンスチューニング事例]なぜ本番で障害が起きてしまったのか
なぜこうなってしまったのか。
まず、先ほど問題としたクエリを発行しているAPIのレイテンシが、もともと2〜3秒と速くなかったところから、さらに遅くなり10秒まで延びてしまいました。
そしてスマホアプリ向けのAPIだったため、スマホアプリが10秒でタイムアウトしてリトライをする設計となっていました。すると、ただでさえ10秒で返しきれずに重くなっているサーバーに、リトライされたリクエストもやってきます。これに耐えきれず障害が起きてしまったというわけです。

なぜ、大きな問題ではなかったはずのクエリが原因で障害が起きたかというと、負荷試験の際には2000行で済んでいたものが、本番では8万行をフルスキャンしていたからでした。
では、どうしてこのように実行計画が変わってしまったのか。
indexはどちらにもあり、行数も同様なので、それが原因とは考えにくい。また、オプティマイザーの評価によって実行計画が変わってしまうことが稀にありますが、それでもない。不思議に思いつつよくよく調べてみると、INNER JOINの箇所をuidで結合していたのが原因だとわかりました。

これは文字列が入ってるカラムで、負荷試験環境では問題なくindexを使って文字列で結合できていたのですが、本番環境ではindexが使えずフルスキャンとなっていました。
なぜか。ヒントは、本番環境はもともとMySQL5.7を使っていて、そこから8にアップグレードしたものであり、一方、新しく作った負荷試験環境は最初からMySQL8を使用していること。
MySQLには「COLLATION」という照合順序に関するルールがあります。これのデフォルトが、MySQL5.7からMySQL8の間で変わっているんです。これが原因でindexを使った結合ができず、障害が起きていました。

こうなった大元の原因はアップグレード時のミスですが、文字列型のカラムでJOINしていたことや、負荷試験で問題がなかったので、CPUの使用率が高いのを見過ごしてしまっていたのも原因でした。
また、タイムアウトの際にどんなリトライの仕方をするのかを意識できていなかったのも問題でした。即時リトライしてしまう仕様にしていた点もよくなかったですね。こうした複合的な理由により、障害が発生してしまったという事例でした。
ではこれを踏まえて、パフォーマンスチューニングの勘所について、そーだいさんとお話できればと思います。
いかにしてwebパフォーマンス障害の原因を突き止めるか
大西:fujiwaraさん、ありがとうございました。fujiwaraさんのお話を聞いてみて、そーだいさんは率直にどのように思われましたか。
そーだい:僕も文字列のindexで苦労した経験があるので、やっぱり難しいんだなと思いながら聞いていました。あとIDって名前がつくと、僕らはintだと思いがちです。でもアプリケーションコードだけではそれを特定することができないために、コードを書く人たちがレビューですり抜けちゃうのもよくある話です。その意味でも難しい問題ですし、聞いていて面白かったですね。本当に、「現場で起きた実際の問題はやっぱり面白い」という好例だなと思いました。
大西:僕はちょうど、MySQL5.7から8にアップグレードするプロジェクトを今進めていているところなので、「しっかりケアにしないとな」と感じました。では再びfujiwaraさんから、パフォーマンスチューニングの勘所についてお話いただけますでしょうか。
fujiwara:ではまず、いかにして原因究明したかをお話していきます。障害が起きた当日は僕はオンコールを受けることはなく、別の担当者が調査をしていました。その時は原因究明ができなかったものの、アクセスが減ったことで自然回復したため、改めて翌日に調査をすることとなりました。
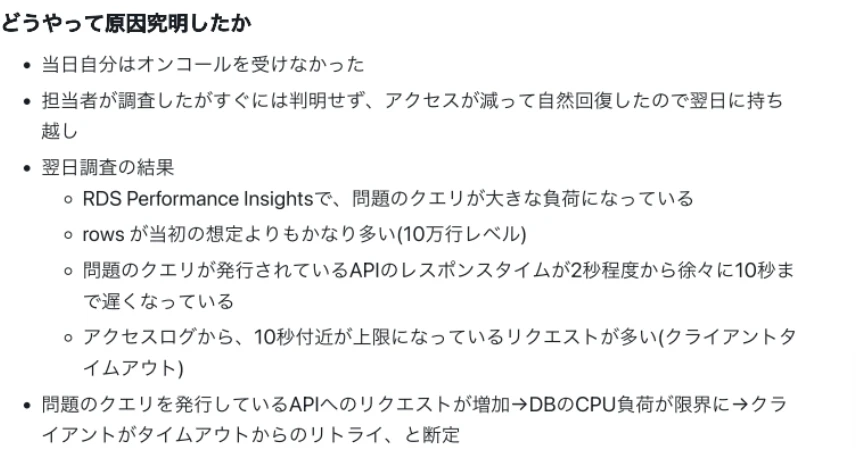
調査の結果わかったのは、
- まず先ほど問題としたクエリに何か欠陥があること。
- 当初2000行のつもりだったrowsが10万行ほどと膨大な量になっていたこと。
- APIのレスポンスタイムをグラフ化してみると、10秒程度が上限になっているリクエストが多いことも判明しました。
これらを複合的に見て、APIのリクエストが増えたことでDBのCPU負荷が限界に達し、クライアントがタイムアウトして、リトライされているのが原因だと断定しました。
大西:もしそーだいさんが同じ状況に置かれた場合、どういった観点で調査を進めて行かれますか。
そーだい:僕もrowsの数はすごく意識しています。取り出してきたデータは100件だから100件しかアクセスしてないように見えても、実際は10万件や100万件のアクセスがあって重くなっていることもあるので、それは確かめるようにしています。
あと今回の場合は原因となるクエリが問題なくわかっていましたが、僕は実際にクエリを実行しながらチューニングし始めることが多いですね。アプリケーション側から見るのかデータベース側から見るのかは、僕とfujiwaraさんの違いとしてあるのかなと感じました。でも、この一連の流れで自分の得意な方はどちらかという違いだけなので、どちらがいい悪いではないと思いますね。
大西:データベース側とアプリケーション側のどちらから見ていくのがいいのか、ご自身の経験から適していると感じる順番はありますか。
そーだい:僕の場合はデータベースが得意なので、アプリケーションコードをいきなり見たりとかアクセスログ見たりするよりは、データベースから特定していくのがいいなと感じていますね。
大西:データの根底からどんどん上がっていって、ユーザーのところまで遡っていくイメージでしょうか。
そーだい:そうですね。
大西:fujiwaraさんはいかがですか。
fujiwara:今回はデータベースだろうと当たりがついていたので、そっちを見て実際すぐにわかったので、比較的悩まなかったかなと思います。ただ、僕の場合は大体メトリクスをまず見ますね。メトリクスがおかしいところを見つけ出して、そこから変なところの原因を探しに行くことが多いです。
メトリクスを見るときには、CDNのリクエスト数とレイテンシ、ロードバランサーのリクエスト数とレイテンシ、アプリケーションサーバーのCPUなどを縦に同じ軸で見られるようにダッシュボードを作っていきます。こうすると、不自然な動きをしてる箇所を見つけやすいです。そこで、変な凹み方や出っ張り方をしてる場所を見つけて、当たりをつけて絞ってくいく感じですね、
大西:メトリクスは適切に作るのが難しい印象があるのですが、メトリクスを作るにあたって意識されていることなどありますか。
fujiwara:僕も経験と感覚で作っているのですが、ミドルウェアごとに大体見るものって決まってくるのかなと思います。例えばロードバランサーなら、リクエスト数とレイテンシ、エラーの発生数ですし、データベースならクエリ数、rows数、CPUの状態、スローログの量などを見ます。経験的にこうしたものを並べてはいますが、どれがいいかって意外とわからないなと僕自身も思っています。
大西:毎回その場その場でそれぞれのリソースに応じて確認して、それをちゃんとまとめていくことが大事なのかなと感じました。ありがとうございます。そーだいさんはメトリクスについてはいかがですか。
そーだい:僕はサーバー監視ソリューションを作っている会社にいたので、自分でダッシュボードを作ったりお客さんにダッシュボードを作るアドバイスをしたりしてきました。そのときによく言っていたのは、最初から完璧なものを作るのは難しいので、「CPUとネットワークとメモリをまず見ましょう」ということでした。
それ以外のものについては、先ほどfujiwaraさんもおっしゃっていたようにミドルウェアに合わせて決めるのがいいと思います。しかしそれがよくわからない場合は、まずは足元の障害に対して、「どうやったらこれに気付けたんだろう」、「どうやってこれに気づいたんだっけ」みたいな話をしながら、少しずつ足していくのが大事かなと思います。
大西:メトリクスを育てる、とてもいいですね。そうしてひとつずつ足していくことで、そのチーム、そのアプリケーションに応じた本当に必要なメトリクスができていくのかなと感じました。
では、続いてのテーマをお願いします。
indexが機能していない原因の発見にむけて
fujiwara:問題のクエリのindexが機能していない原因をいかにして見つけたかですね。
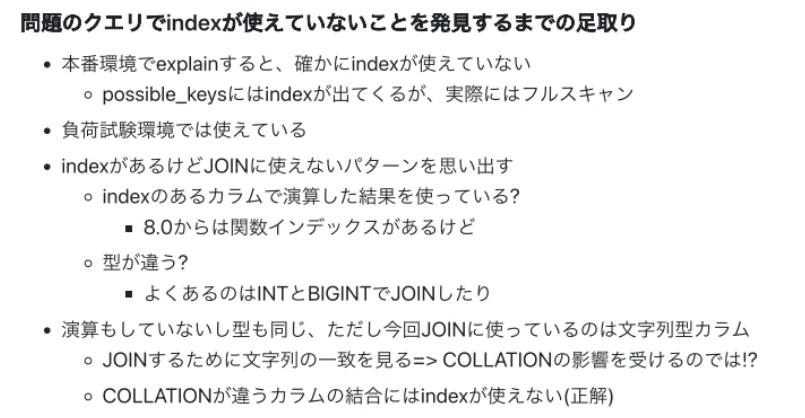
本番環境でexplainした結果、indexが出てはくるものの、フルスキャンしていることがわかりました。一方、負荷試験環境ではindexを使えているので正直悩みました。
indexはあるもののJOINに使えないパターンを思い出しつつ、検証して可能性を潰していきました。そのなかで、「そういえばMySQL8.0でCOLLATION変わったけどちゃんとケアしてたっけ」と思い、見てみたら案の定違っていて、原因の特定に至ったわけです。
一応ちゃんとCOLLATIONを本番と合わせて、ステージング環境のほうで実行してみて、これやっぱり同じになりますねってことがわかったと。そういう感じですね。
大西:ありがとうございます。fujiwaraさんも迷われたということですが、今回のように特定の事象が起きるパターンを並べたもののそのどれも起きていない場合、次の一手はどう打つべきなのでしょうか。
fujiwara:今回は、たしかテーブルが4つぐらいJOINしてたのですが、それを外していって、4個から3個、3個から2個にしたり、サブクエリをダミーの値にしたりしつつ、どのテーブルが残っていると使えないのかを特定していって、という感じでしたね。
大西:すごく面白いです。アプリケーションの実装で不具合が発生したときにどんどんコード剥がしていくのと同じような感覚で、JOINもどんどん剥がしていって原因を特定していくと。そーだいさんはいかがですか。
そーだい:僕だったら、まずは該当のテーブルのDDLを読みます。そして自分の想定してるデータ状態かをテーブルのレポートで確認して、それからSQL確認するという順番でやることが多いですね。そこから先は比較的共通していて、想定通りのテーブルだし想定通りのレコード入ってるのに、思ってる通りの実行計画にならないのであれば、JOINやクエリをバラしていきます。今回のケースだと、isフラグやORDER BYをなくしてみたりしつつ、ひとつずつ潰していくイメージですかね。
あとはやっぱり本番とテストでステージングが違うことは非常によくあるので、それを最初に確認するのは大事だなと思います。
大西:ありがとうございます。現状と自分の感覚をまず揃えて、そこからは地道に少しずつ削っていくことですかね。では続いて、モニタリングについてお話しいただけますか。
障害を未然に防ぐためのモニタリング方法
fujiwara:今回の反省点として、モニタリングが足りなかったことがあります。普段はMackerelでモニタリングすることが多いのですが、今回の案件では入れられていませんでした。CloudWatchとRDS Performance Insightsのみでのモニタリングでした。
僕はいつもrowsのリードを見ています。というのも、これが多いと何か問題があることが多いからです。ただ、RDS Performance Insightsではrowsが見れるのですが、CloudWatchには実はrowsのメトリクスがないんですね。そのため普段に比べてモニタリングができておらず、それが障害の一因となってしまいました。
大西:なるほど。これに対するソリューションとしてはMackerelでモニタリングしてたらよかったということなのでしょうか。それともCloudWatchのままで、rowsをモニタリングしやすくする方法はあるのでしょうか。
fujiwara:CloudWatchでなぜ見れないかというと、SQLでデータベースのなかを覗かないと取れない値だからなんですよ。AWSは基本的に、お客さんのデータベースに勝手にアクセスすることをしないのでCloudWatchでは難しいかなと思いますね。
大西:なるほど。だからこそMackerelのような、内部まで見れるモニタリングツールが有用になってくるわけですね。そーだいさんはモニタリングについてどう思われますか。
そーだい:僕は先人の知恵を借りるのが大事だなと思っています。今のfujiwaraさんの話も、こうして聞くことで自分たちで失敗する前に気をつけられるじゃないですか。こうして先人の知恵を借りて、罠を避けるようにメトリクスを活用していくことが大切ですね。何のために先人はこのメトリクスを取ろうと思ったのか、どんな風に活用するのかを1個ずつ調べていって、「僕たちはこれを活用できそうだ」と思うものを足しながらダッシュボード作っていくのがいいのかなと思います。
大西:とはいえ、それは簡単ではないと思うのですが、そーだいさんはどのように先人たちの知恵を吸収していますか。
そーだい:考えることですかね。ツールはそもそも何かの問題を解決するために作られているので、なんのために作ったんだろうと考えたり、どうやって活用してるんだろうと調べたりすれば、開発者の声やユーザーブログなどから知識を蓄えられます。それをもとに、こういう観点でこれがあるんだなと考えながら進めていっていますね。
大西:ありがとうございます。では、最後のトピックに移ります。
ISUCONでこのネタを扱わないのか?
fujiwara:「ISUCONでこのネタはありだったか」というテーマですね。ちょうど今回のケースが今年の作問期間に起きました。作問期間にアドバイザーだったこともあって、これをネタとして入れたら面白いかな、と思ったのですが、さすがに罠すぎるなと思ってやめました。
今年は予選がなくて、本選一発だったのもありますね。予選があったら本選に入れてたかもしれないです。予選は初心者の人も結構来るので、やめておいた方がいいかな、と。あとはこの障害に関わった弊社のメンバーが選手として出ているので、公平性の観点からも出題は見送りました。
大西:ここだけしか聞けないような裏話、ありがとうございます。ISUCONはエンジニアをしていると頻繁に目にするイベントではあるものの、実際の実務とISUCONって乖離があるような印象でした。でも今の話を聞いた感覚では、そんなに乖離していないのかなと感じました。fujiwaraさんは実務とISUCONの距離感をどのように捉えていますか。
fujiwara:どうしても競技なので、競技の練習をした人が強くなっちゃうのは仕方がない面もありますが、実務の要素はなるべく入れたいなとは思いながら作っています。
作問するにしても、自分の体験したことをネタにすると、やっぱり考えやすいんです。なので密接というほどではないけど、そんなに遠くもない距離感ですかね。
大西:なるほど。実際に実務で起きたことに着想を得て作られてるんですね。ありがとうございます。そーだいさんは、もしISUCONに出たときにこの問題が来たらどうしようみたいなのってありますか。
そーだい:僕はでも逆にクセの強い問題があった方がいいと思っていて。その時はわからなくて悔しいけど、それをきっかけに記憶に残って定着するんですよね。僕も昔解いたクセの強い問題、いまだに覚えています。ISUCONってそういう疑似体験の場所でもあるのかなと思います。
大西:そんなこんなでそろそろ終了のお時間が迫っています。非常に実践的なディスカッションで、とても勉強になりました。ありがとうございます。
AI 時代のエンジニア転職は Offers で
あなたのキャリアに合った求人やスカウトが届く、エンジニア向け転職サービスです。
無料ではじめる正社員の求人を探す
Offers Jobs で正社員の求人を探せます。
求人を見る関連記事
 イベントレポート
【イベントレポート】人間のレビューなしで"そのまま出せる"デザインは作れるか こぎそさんに聞く デザインハーネスの現在地
AIに画面を作らせても、人のレビューは要るのか。デザインハーネスを提唱するこぎそ様が、4層モデルとデモ、レビューコメントから判断基準を育てる実践、人が判断を残すべき領域を語りました
株式会社Lumilinks 代表取締役 / デザイナー
こぎそ 他1名
 イベントレポート
【イベントレポート】AIでコード書く前に、要求・要件定義足りてる?ミノ駆動さんと改めて考える ドメイン駆動設計
設計・実装がAIに移った今、人間に残る要求・要件定義をどう考えるか。『良いコード/悪いコードで学ぶ設計入門』著者のミノ駆動様が、文脈・未知の未知・アウトカム・仮説推論の4つの思考と、現場の問いへの答えを語りました
合同会社DMM.com
ミノ駆動 他1名
 イベントレポート
【イベントレポート】【Claude Code】世界のスタートアップが必死に求める「GTMエンジニア」とは
#GTMLab主宰のなかむらまこと氏とLayerXの飯沼広基氏が登壇。GTMエンジニアは何をエンジニアリングするのか、なぜエンジニア出身が向いているのかを、効率化ではなく売上を伸ばす開発の実践とともに語りました。
#GTMLab 主宰
なかむら まこと 他2名
 イベントレポート
【イベントレポート】AI時代 Drizzle?Kysely?Prisma? kennさん・cojiさんと語るORM選定
AIがコードを書く時代にORMをどう選ぶか。KyselyとD1でDBを2回吹き飛ばした溝口浩二(coji)様と、DrizzleとAtlasでスキーマだけを見るKenn Ejima様が、型・マイグレーション・DB選定で人が担う判断を語りました
Dot Product AI, Inc. Founder
Kenn Ejima 他2名
 イベントレポート
【後編】MIT、GPL、BSL?何をしたら違反になる?ケースから学ぶ OSSライセンス講座 #DeepDive
【前編はこちら】 Contents1 ディスカッション・質疑応答1.1 【OSS
バーチャルテックポエマー
紅月/koduki 他1名
- イベントレポート
【前編】MIT、GPL、BSL?何をしたら違反になる?ケースから学ぶ OSSライセンス講座 #DeepDive
Connpass詳細はこちら アーカイブはこちら 2024年09月11日、株式会
バーチャルテックポエマー
紅月/koduki 他1名