AIがコードを書き、人間はもう読まない。そうなったとき、ORMは何を基準に選べばよいのでしょうか。
「型補完がどこまで効くか」「直感的に書けるか」。これまでのORM選定は、人間にとっての書き味が中心でした。書き手がAIに替わった今、その軸は少しずつ意味を失いつつあります。
2026年9月9日の #Offers_DeepDive に、Dot Product AI, Inc. Founder のKenn Ejima様と、株式会社TechTalk プログラマーの溝口浩二(coji)様をお迎えしました。お二人とも、すでに自分ではコードを書いていません。
モデレーターの大西政徳様の進行で、Kysely・Drizzle それぞれの実践と、AI時代にそれでも人間が判断し続けるべきことをうかがいました。
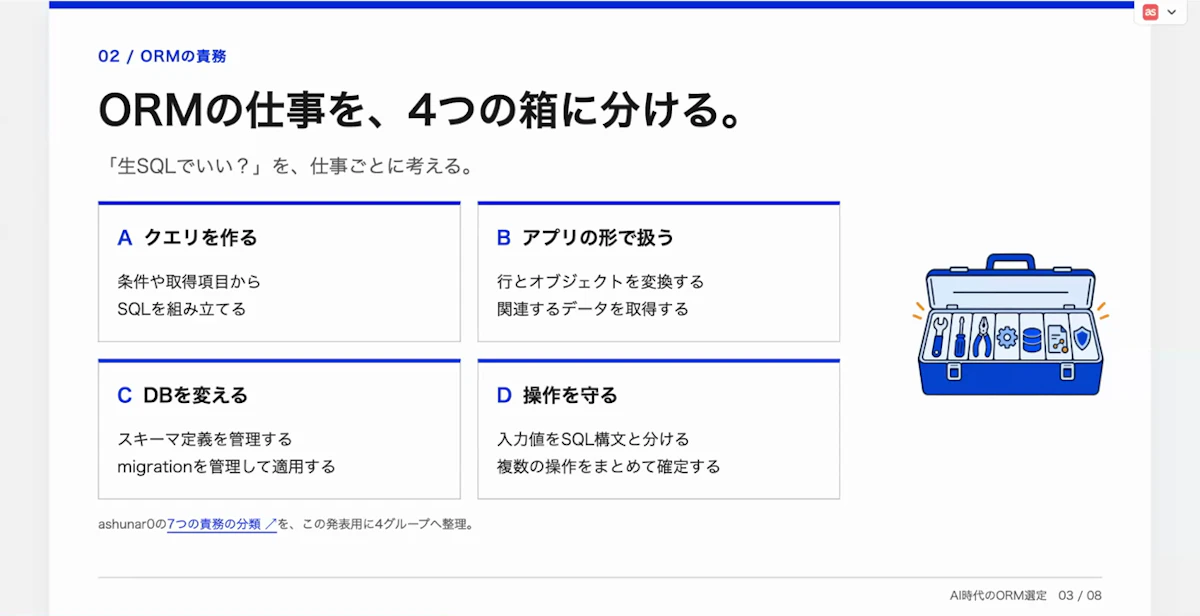
ORMの仕事を4つの箱に分けて考える
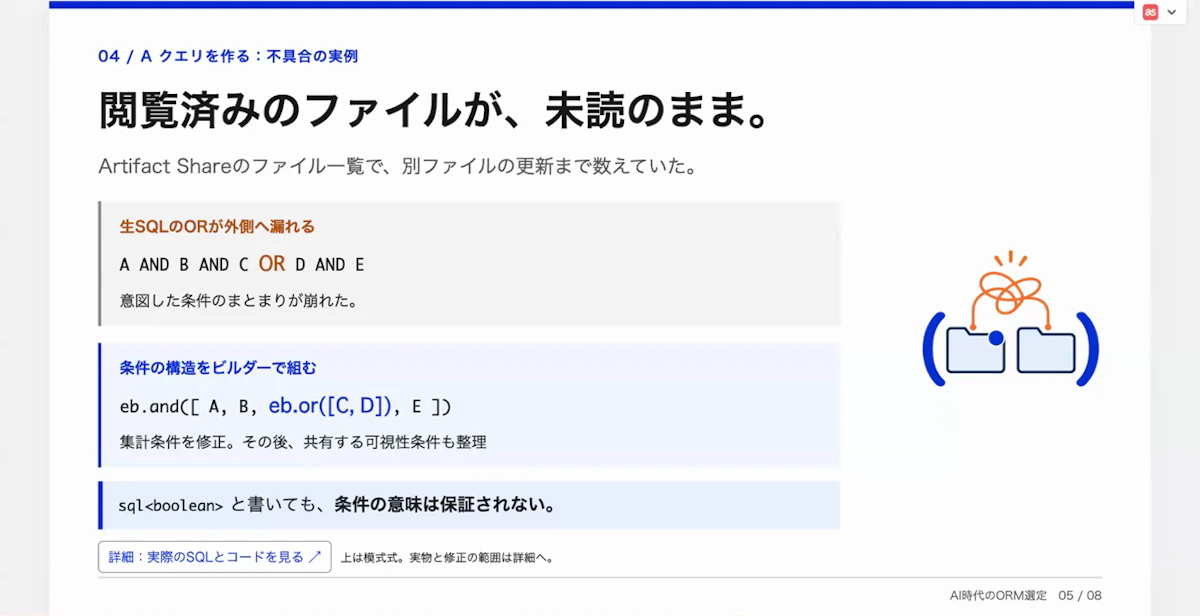
AIは生SQLで型をすり抜けた
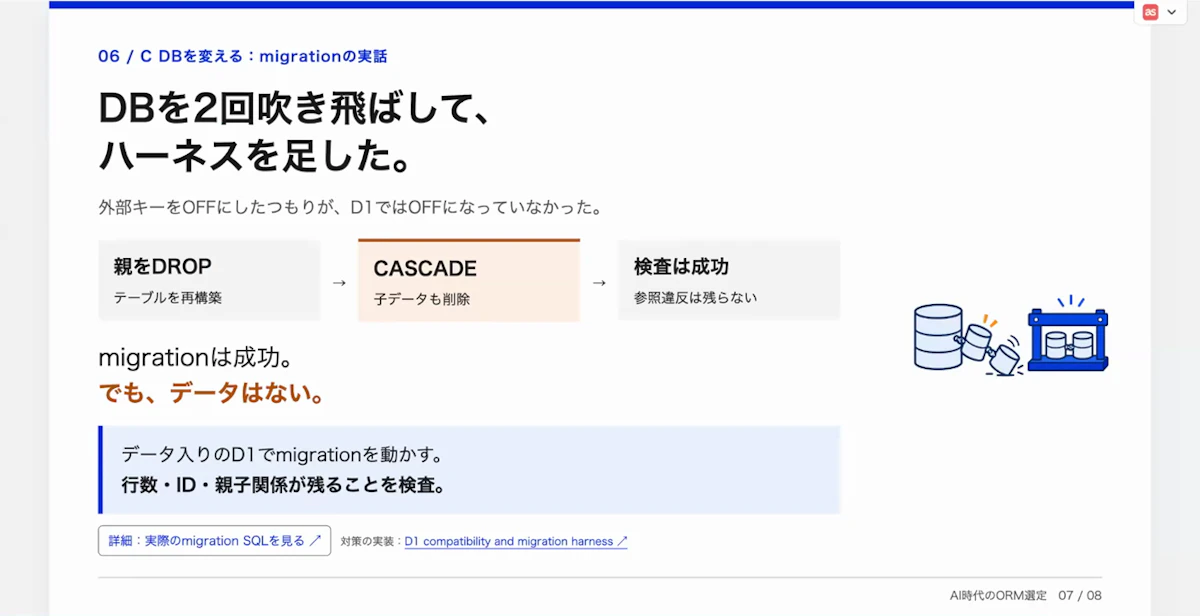
D1のマイグレーションでDBを2回吹き飛ばした
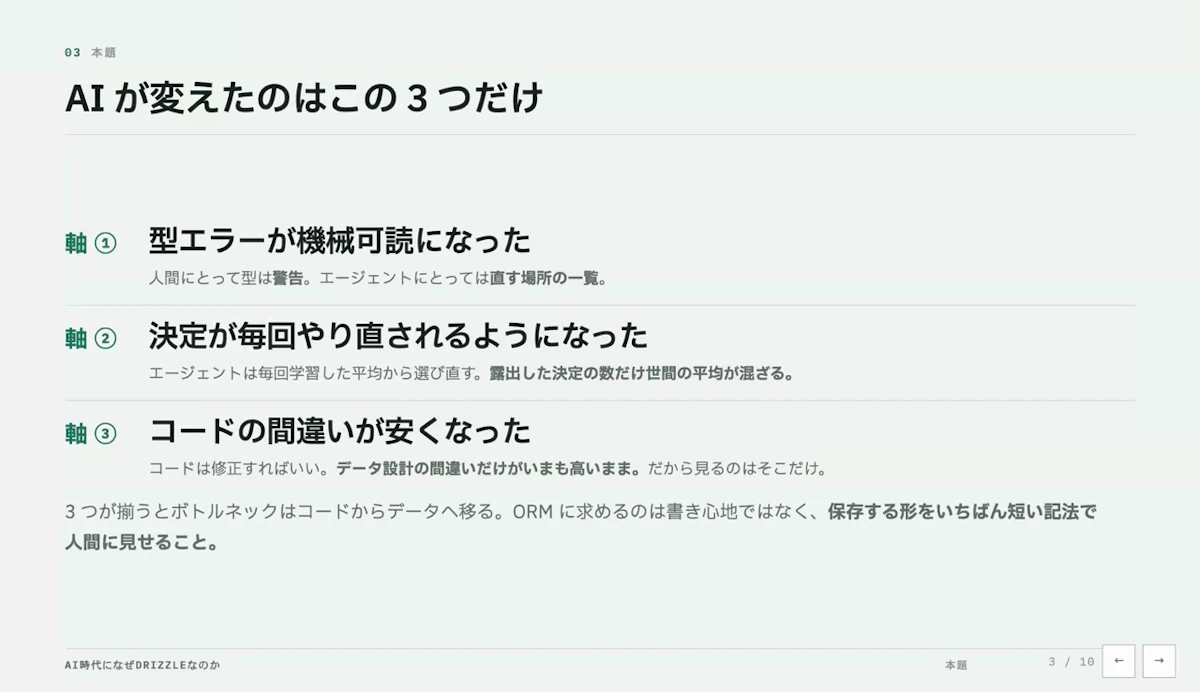
AIが変えた3つの軸と、ボトルネックがデータに移った理由
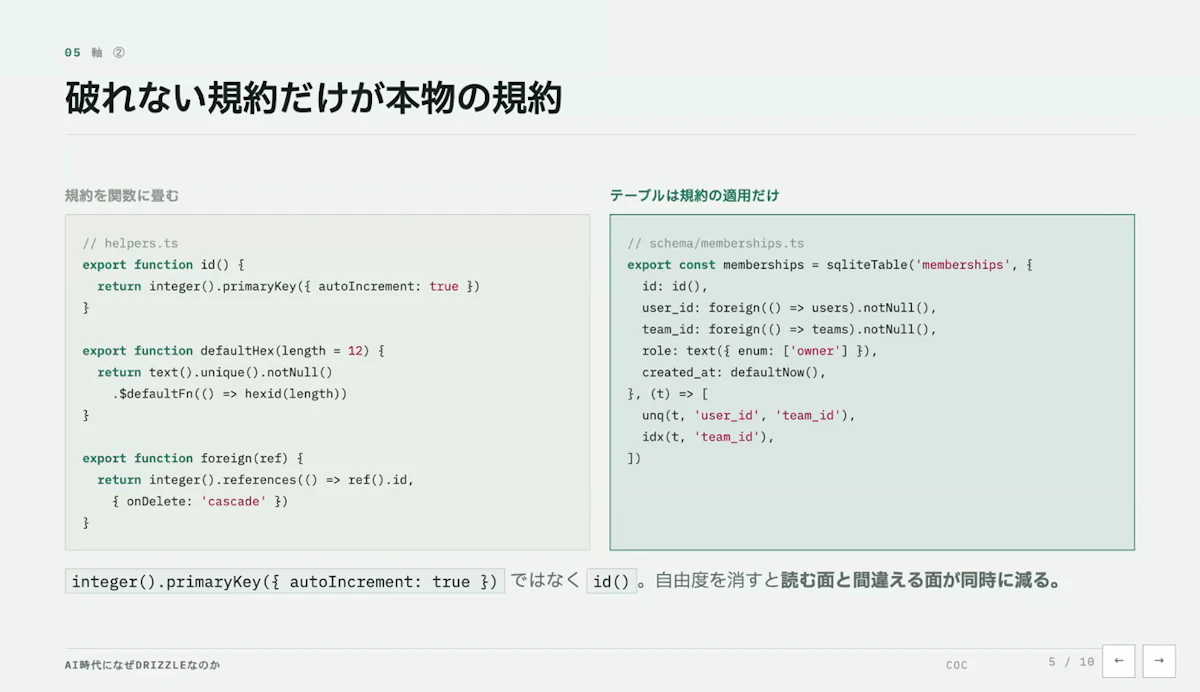
破れない規約をDrizzleのヘルパーとテストで守る
履歴型から宣言的マイグレーションへ
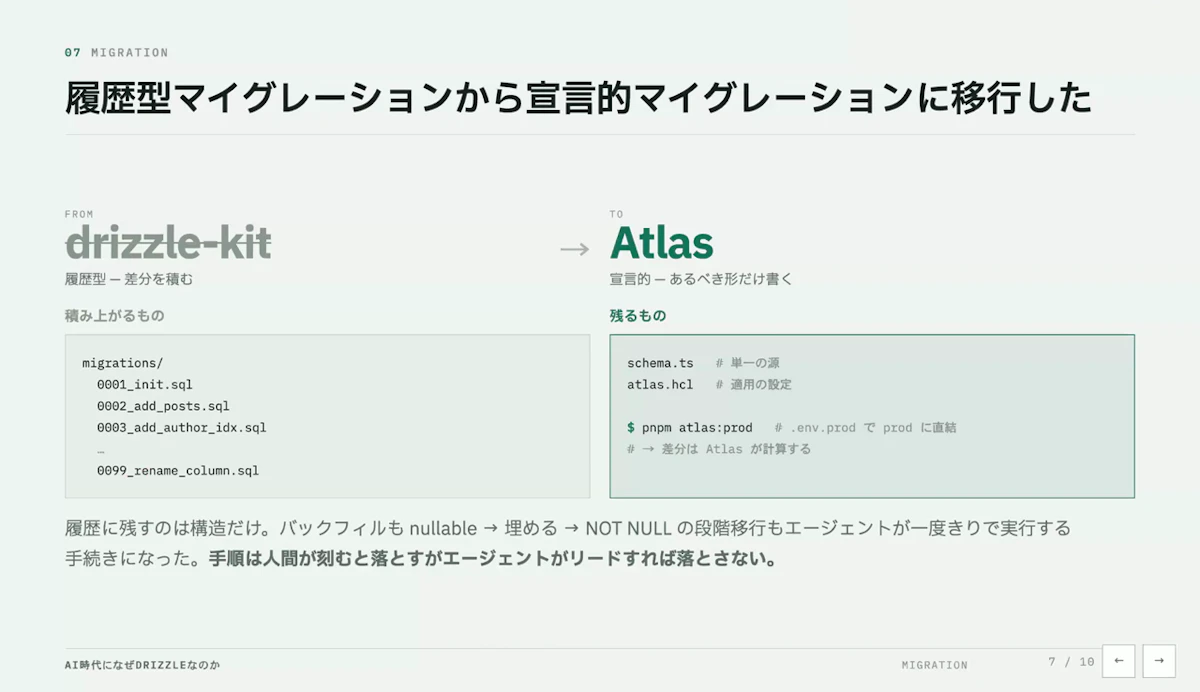
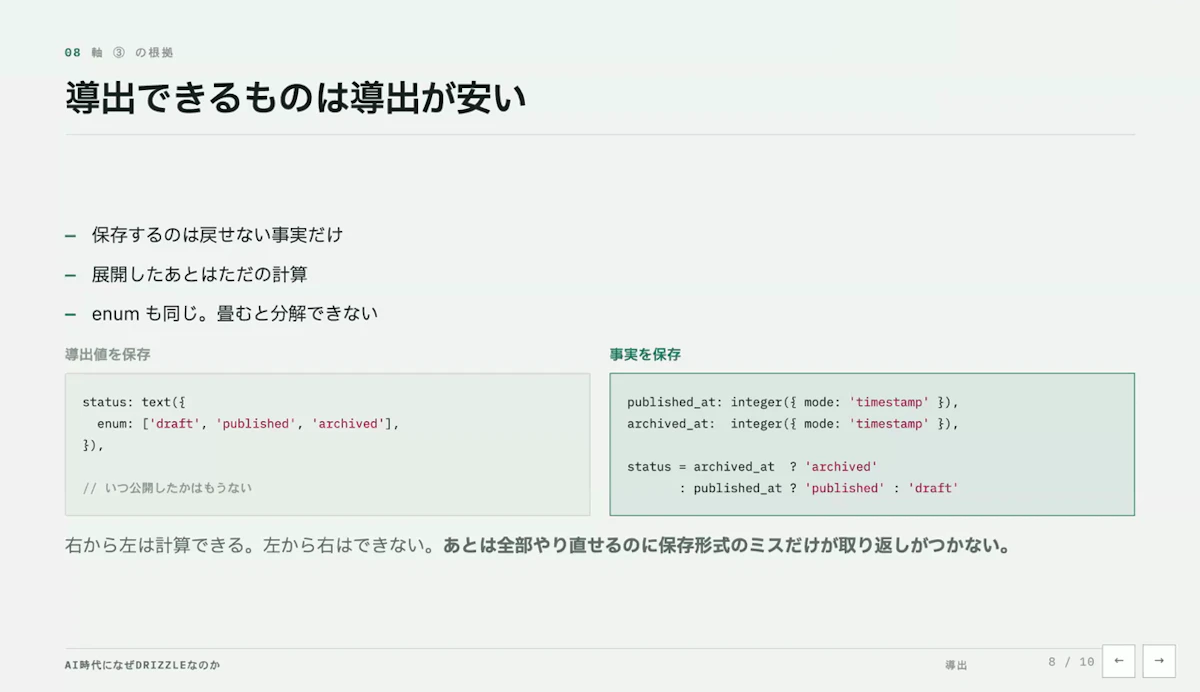
導出できるものは保存しない、スキーマ変更だけは人が承認する
――大西様:溝口様、Ejima様の発表を受けていかがでしょうか。
溝口様:Drizzle良さそうですよね。AIが使いたければですが、idやdeleted_atのように制約をつけられるのはすごくいいと思いました。実はDrizzleという名前の語感が苦手で食わず嫌いでしたが、機会があれば使ってみたいと思うようになりました。
Ejima様:書き方が2系統あるのも混乱するポイントかもしれません。クエリビルダー的に自由に組む書き方と、Prismaっぽいリレーションを取ってくるAPIがあり、どちらを使うかで迷うところはありそうです。
溝口様:マイグレーションで最初に引っかかったこともありましたが、Atlasを使えばいい、というのは確かにそうなので、入りやすいと感じました。
型はAIのための最前線のガードレールになった
――大西様:型安全なORM・SQLは、今でも重視していますか。
溝口様:大事だと実感しています。バグったので。人が書いてもAIが書いても、アシストがあるのはいいことでしょう。あえて外さなくてもよく、あった方がバグは少なくなると感じています。
Ejima様:僕は逆に、アンチ型だったんですよ。Rubyから来た人間なので視覚的なノイズを入れたくなく、_idと書いてあればIDに決まっている、という感じで人間の負荷を減らすことを大事にしていました。
それがAIで書くようになって、逆に型をめっちゃ大事にするようになりました。認知能力の高い機械が見てくれるなら、二重三重のガードレールがかかっている方がいいからです。
――大西様:ガードレールとしてはテストもあります。型ではなくテストでカバーできる、という意見についてはどう思われますか。
Ejima様:僕の中では、型が一番前のディフェンスで、次にリンター、最後がテストです。リンターはAIが賢いのですぐ迂回してしまい、あまり頼りになりません。テストは実行に時間がかかるので、普段は型のレベルで片付くものは片付けます。
スピードと軽さと重要さで二段階に分けている形です。ただ、テストでしか書けないものも結構あるので、その組み合わせだと考えています。
ORMとデータベースの選定基準は別物
――大西様:PostgreSQL・MySQL・SQLiteといった、データベース自体の選定は今でも重要でしょうか。
溝口様:めちゃくちゃ大事です。AIがコードを書く観点ではなく、性能やスケールの観点で気にします。
僕はクライアントワークで新規事業の開発が多く、ヒットするか分からない中でお金も手間もかけたくない。けれどレスポンスはめっちゃ大事です。そうすると結果的にCloudflareやVercelになり、データベースはTursoなどSQLite系に寄っていきます。
一方で業務オペレーションが絶対に大事という話になると、やはりPostgreSQLがメインになってきます。
Ejima様:全部言われた通りです。リードが速いSQLiteはB2Cでスケールを追求するなら選び、一般的な業務システムならPostgreSQLにいきます。ただ比率としては、SQLiteがどんどん増えているのが実情です。
自分も新規はすべてSQLite系で、Tursoなどをメインで使っています。業務で使えないという先入観はだいぶ覆ってきました。業務でPostgreSQLしか触ったことがない方は、SQLiteを掘ってみてはいかがでしょうか。
――大西様:ORMの選定基準とデータベースの選定基準は、別のものとして捉えた方がいいと分かりました。
Ejima様:プログラミング言語は最悪入れ替えられますが、データベースの入れ替えは本当に大変です。データが溜まると変えにくく、最初の選定が後々まで効いてきます。アーキテクトの仕事として大事なのは、データベースの選定だと思います。
――大西様:溝口様は、プロダクトがうまくいったときにD1から別のデータベースへ移る可能性はありますか。
溝口様:最初に検討しました。DAUが100万になってもD1で大丈夫かとAIにめっちゃ相談したところ、リードレプリカもできるしグローバルに分散しているので、むしろこっちの方がいい、考えすぎだと言われて、そうしています。
最初に試算はしていて、段階的にこうなったらこうしよう、とは一応考えています。ただ、そこまでいかないケースが8割方です。その時に考えると割り切りました。
マイグレーションとスキーマを人はどこまで見るか
縛りプレイで見ない溝口様、DDLだけ見るEjima様
――大西様:DBマイグレーションは、どこまでちゃんと見ていますか。
Ejima様:DDL文だけはちゃんと見ることにしています。スキーマはDrizzleのTypeScriptで書き、1行足してAtlasを叩くと、ADD COLUMNのようなSQL文が生成されて「実行しますか?」と聞いてきます。それをじっと見て、大丈夫そうなら進める形です。
データベースで唯一グリップしているのは、このデータ構造の変更の部分です。
溝口様:縛りプレイなので見ないようにしています。D1が吹っ飛んだ後も我慢しています。AIが自分でハーネスを作るのを試したいんです。完全にAIに任せ、事故ったらガードレールを自分で作ってもらう。それを繰り返す実験でもあります。
ただ、すでに課金してくださっている企業ユーザーもいて、今吹っ飛んだら大変です。見なくていいように、リアルタイムバックアップを必ず取り、いつでも巻き戻せるようにしています。マイグレーションのクエリをちゃんと見たのは、今日が初めてかもしれません。
不安になることはあります。DROP TABLEで消えた直後は、予行演習のissueを作ってAIに実行してもらいました。新しい本番DBを作ってダンプを入れ直したり、バックアップから完全復旧できるかを試したりもしています。データベースがまだ小さいからできることですが。
Ejima様:僕もそれで思ったのは、ドライランをめっちゃやるようになりました。本番にデータを投入するスクリプトなら、どれぐらい影響があるか、データを書き換えるギリギリのところまでAIに書かせてから実行します。
以前はスクリプトを実行するときに緊張感がありましたが、ギリギリまでドライランを書かせることで安心感を持てるようになりました。コードが安くなったので、コードで担保できるところはギリギリまで攻めよう、ということです。
溝口様:SQLiteはそれがいいですよね。ファイルで済んじゃうから。
AIが出したスキーマを信じるか
――大西様:AIが出したDBスキーマを、どこまで信じていますか。あとからおかしいと気づいたらどうしていますか。
Ejima様:規約やヘルパーを必ず使わせているので、そこから逸脱していなければ、パッと見て何をやろうとしているかが分かります。信じるというより、見た時点で分かるんです。他のコードは読んでいないので、そこだけを見ています。
おかしいと気づいたら、それは設計が狂っているサインです。「これは絶対おかしいでしょ」と突っ込むと、CodexでもClaude Codeでも「そうでした」と言ってきます。
データは一回書いた後に直すのが大変なので、水際で防ぐのがいい。だから機能の開発を始める前に、スキーマを変えるなら「一回承認を取らせてください」とCodexが言ってきます。サンプルを見てこれならいいよと言えば、ガーッと開発が始まるので、30分ぐらいどこかに出かけてくる感じです。
溝口様:僕はただ信じています。Artifact Shareは僕一人から、今はユーザーが300人ぐらいになり、最初に課金してくださった会社では社内で200人弱が使っています。課金のニーズが出たときはまだ課金機能もなく、スキーマをめっちゃ考えなきゃとは思いました。
ただ、社内で広がったときにどんな機能が必要になるか、全然分かりませんでした。いきなりエンタープライズ的な機能が要るかもしれないし、200人で監査などは出てこない気もする。先に考えたら絶対考えすぎになります。
そこで、分かっている範囲で一旦そのまま作ってもらい、実際のデータが溜まってから、使われ方を見てスキーマを考え直しました。全く新しいスキーマへの入れ替えを2回やっています。
大事にしたかったのはサクサク感です。何回もクエリすると1秒かかるようになるので、joinもせず一発で済ませたい。そうするとデータ構造がガンガン変わるので、その時に分かっている範囲で最適化するしかない、と割り切りました。その結果が「信じています」です。
――大西様:スキーマを入れ替えるとき、AIにはどう指示しているのですか。
溝口様:例えば「ページロードが0.5秒ぐらいになった、昔は0.1秒だったのに」と、体感をそのまま伝えています。どうしたらいいか聞き、本当か分からないので、データやトレースを見てもらう感じです。
――大西様:大規模なスキーマ変更は、どうやってプロダクションに適用していますか。
溝口様:そこはCloudflareとD1のいいところで、全く同じものを別のWorkerと別のD1で作れて、データもダミーで作れます。全然別の環境で実測して、確認してもらうわけです。それがフィットすると思って、Workersを使っているところもあります。
データを吹き飛ばした経験と、スタックの選び方
――大西様:AIに任せてデータを吹き飛ばした経験はありますか。そこから何を学びましたか。
Ejima様:僕は慎重タイプなので、まだ飛ばしたことがないんです。飛ばしたら心が折れるんじゃないかと思っています。
溝口様:やっぱり二重化とバックアップですね。あとは吹き飛ばすたびにハーネスを作ってもらっていますが、気がつくとハーネスが本体より大きくなるんです。ハーネスのせいで開発が遅くなります。
途中で減らすのは結構勇気がいります。何がエッセンスかを考えてもらうだけなのですが、「なんか遅いな」と気づくのが大事かもしれません。
例えば、issueからプルリクエストが上がってマージ可能になるまで5時間もかかっている。こんな簡単なものなのにおかしいと調べてもらうと、レビューを50回繰り返していた、ということがありました。エンジニアリングマネージャーが、みんなの動きがおかしいと感じるのと同じだと思います。
――大西様:Cloudflareスタックのような先進的な構成と、AIや初心者に優しい構成、どちらを選びますか。
溝口様:アプリの要件次第です。今日の話は僕のサイドプロジェクトですが、B2Bのお客様で個人情報を必ず国内に置く必要があれば、Cloudflareは無理です。GCPやVercelの東京リージョンなど、それぞれに合わせます。あまりAIに合わせようとは思っていません。
Ejima様:AIは何でも知っているので、合わせる必要はないと考えています。僕は初心者寄りで、VercelやTursoのようなベーシックなものを選んでいます。Cloudflare Workersはすごく面白いのですが、制約を覚えておく必要があり、脳内メモリーを食うんですよね。
普通にNodeのインスタンスが上がる、以上、というシンプルなものが好きです。僕自身がGista.jsという初心者向けのスタックをメンテしていることもあり、初心者が使うものを自分でも使っています。
質疑応答
D1の10GB制限は厳しくないか
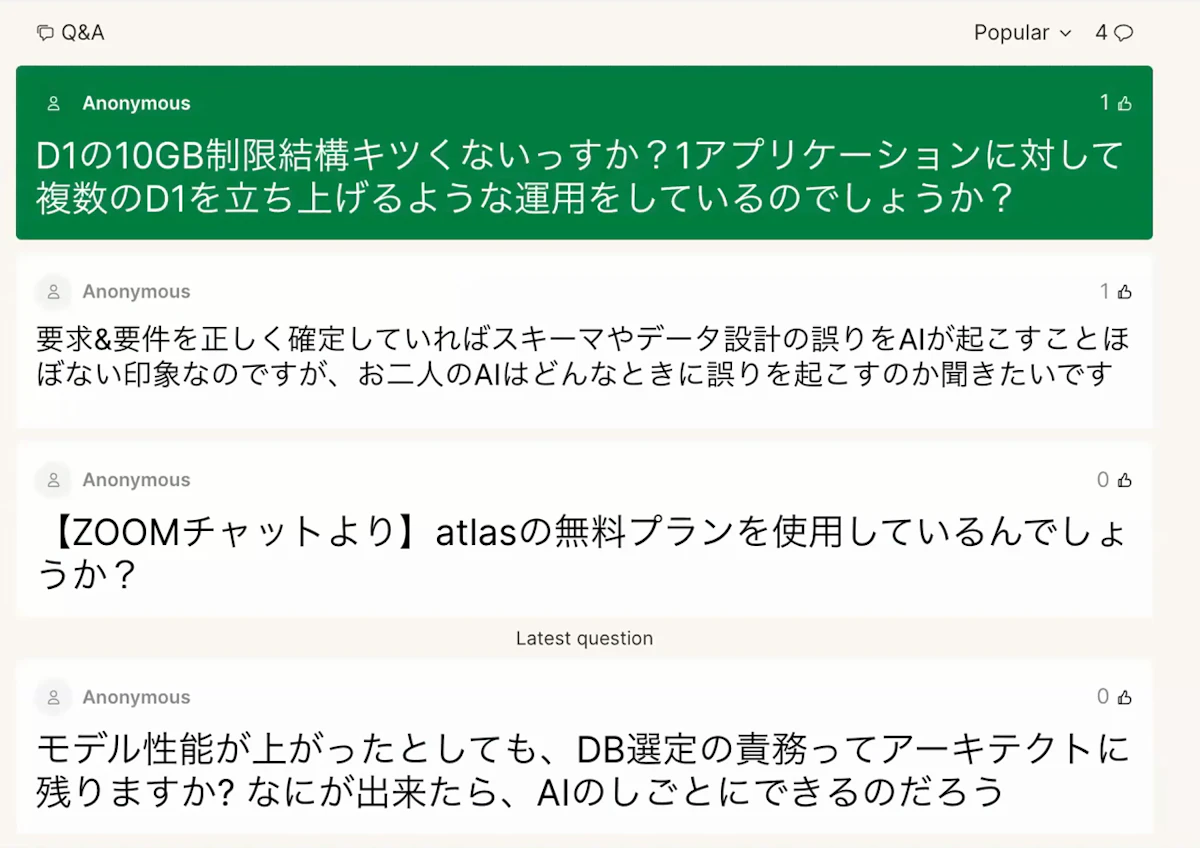
――質問:D1の10GB制限は結構きつくないですか。1アプリケーションに対して複数のD1を立ち上げる運用をしているのでしょうか。
溝口様:同じように心配して、AIにめっちゃ相談しました。結果、D1は1つです。マルチテナントはデータベースを分けるのが公式の推奨ですが、まだユーザー300人なので「早すぎる」と言われ、そうだねとやっています。
AIがスキーマを誤るのはどんなときか
――質問:要求と要件を正しく確定していれば、AIがスキーマやデータ設計を誤ることはほぼない印象です。お二人のAIはどんなときに誤りを起こしますか。
Ejima様:要求や要件を正しく伝えられていないときではないでしょうか。手を抜いて説明すると、お互いの認識がずれたまま進みます。人間同士のミスコミュニケーションと同じことがAIでも起きていて、作っている途中で「あれ、違うぞ」と気づくことはあります。
データで手戻りが起きると、直しにすごく時間を取られるんですよね。なのでデータの定義だけは水際で押さえる方が、時間を無駄にせずに済みます。僕はケチなのでマイクロマネージャー的に細かく見て、問題があればすぐ介入していますが、それでもミスコミは起きます。
溝口様:誤りというより、Codexが本当にオーバーキルをしてくるんです。心配性で、セキュリティ系や正規表現が出てくると、スキーマも含めてすごいものを作ってきます。完全なパーサーを作ろうとして5時間を超えるので、まだそんなに要らないよ、と気をつけています。
Atlasは無料プランか
――質問:Atlasは無料プランを使っていますか。
溝口様:無料です。D1以外のプロジェクトでAtlasを使っていますが、無料版なのでストアドプロシージャなどは使っていません。
Ejima様:僕も無料です。他のツールはあまり知らないだけかもしれませんが、Atlasに特に不満はありません。
――大西様:PrismaやDrizzleではマイグレーションのロールバックが面倒なことがあります。Atlasではどうですか。
Ejima様:追加した行を消すだけです。宣言なので、正しい姿を描けば勝手にDROP COLUMNを書いてくれます。upやdownといったステートを持たないのが、宣言的なものの良さです。
DB選定はAIの仕事になるか
――質問:モデル性能が上がっても、DB選定の責務はアーキテクトに残りますか。何ができたらAIの仕事にできるのでしょうか。
溝口様:AIに伸びてほしいのは、時系列の理解です。AIに小説を書かせると、最初にネタバレを出してしまうとよく言われますよね。本来は未来のことなのに、最初から犯人を言ってしまう。
データベースは生き残って成長していくもので、フィットするものも変わっていくはずです。それを予測してロードマップを考えるのが、今のAIはまだそれほど上手ではなく、一点だけを見ている感覚があります。そこは今のところ、人に残っている部分でしょう。
Ejima様:知識としてはAIに十分あって、それを引き出すのが難しいだけだと思います。結局は要件をどこまで与えるかではないでしょうか。
例えば同じ行を更新しまくる要件なら、PostgreSQLは追記型のアーキテクチャなのでガベージコレクションが走り性能が落ちる。AIはそこまで知っています。ただ、そう質問しないとそう答えてくれません。結果的に、人間側にその知識がないと困るのだと思います。
おわりに
コードを読まない開発を突き詰めたお二人が、そろって最後まで手放していないのが「データ」でした。溝口様はバックアップとハーネスで、Ejima様はスキーマ変更の承認ゲートで。守り方は違っても、データの間違いだけは取り返せない、という認識は共通しています。
ORMを選ぶ前に、自分のプロダクトでデータをどう守るか。今日のお二人の実践は、その問いから考えるためのヒントになるのではないでしょうか。