資料はこちら
位置情報データをコスト最適化しつつ分析に生かすためのデータ管理と運用方法についてというタイトルで話していきます。
資料はこちら
位置情報データをコスト最適化しつつ分析に生かすためのデータ管理と運用方法についてというタイトルで話していきます。
株式会社Luup COO室 Data Engineering Team
河野 匠真2022年に株式会社Luupに入社し、データエンジニアとしてデータ基盤の構築から運用を主に担当しつつ、データ活用領域の拡大にも取り組んでいる。
まず、LUUPの概要について簡単に説明します。
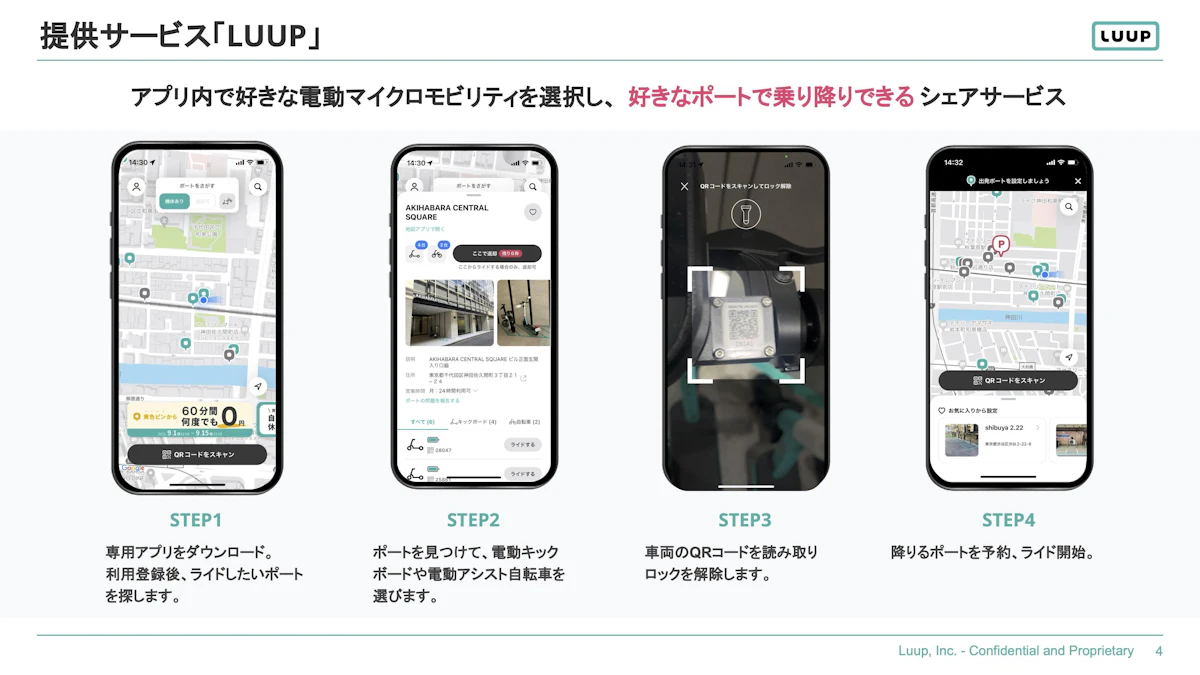
アプリ内で好きな電動マイクロモビリティを選択して、好きなポートで乗り降りできるシェアリングサービスを展開しています。
お客様には以下の流れでサービスをご利用していただいています。
STEP1:専用アプリをダウンロード。利用登録後、ライドしたいポートを探します。
STEP2:ポートを見つけて、電動キックボードや電動アシスト自転車を選びます。
STEP3:車両のQRコードを読み取りロックを解除します。
STEP4:降りるポートを予約、ライド開始。
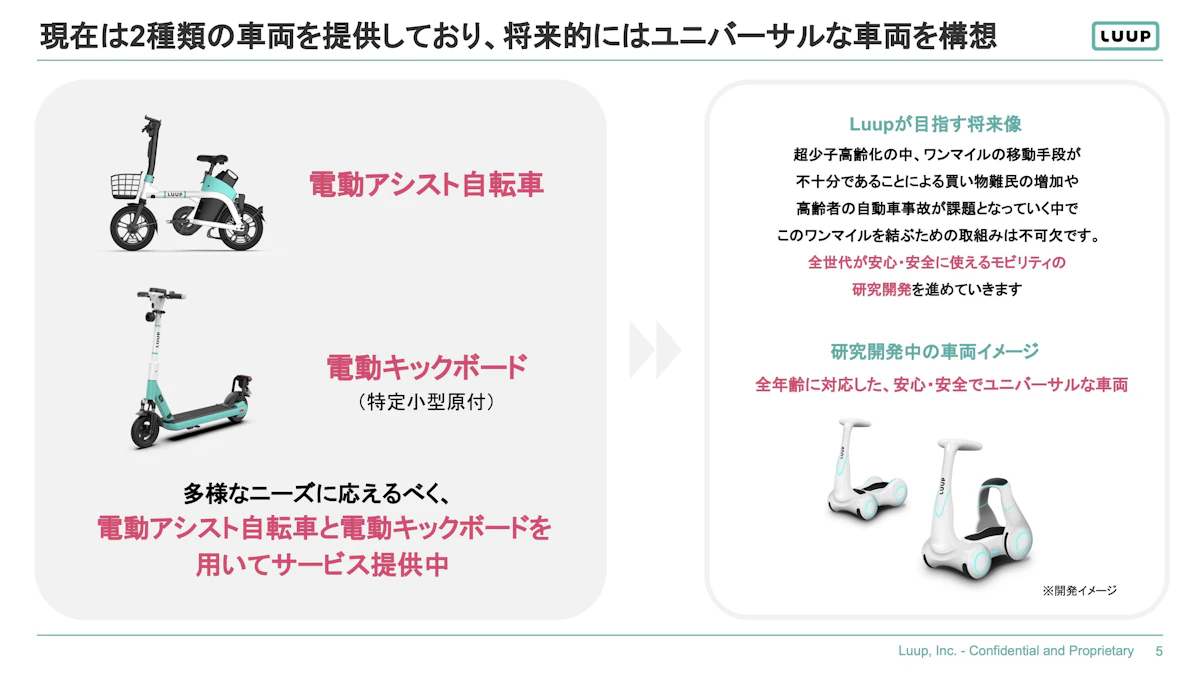
現状は電動アシスト自転車と電動キックボードの2種類の車両を展開しています。
基本的にはこの車両の進化を目指しながら、今後は他の種類の車両を展開していく予定で研究・開発を進めています。
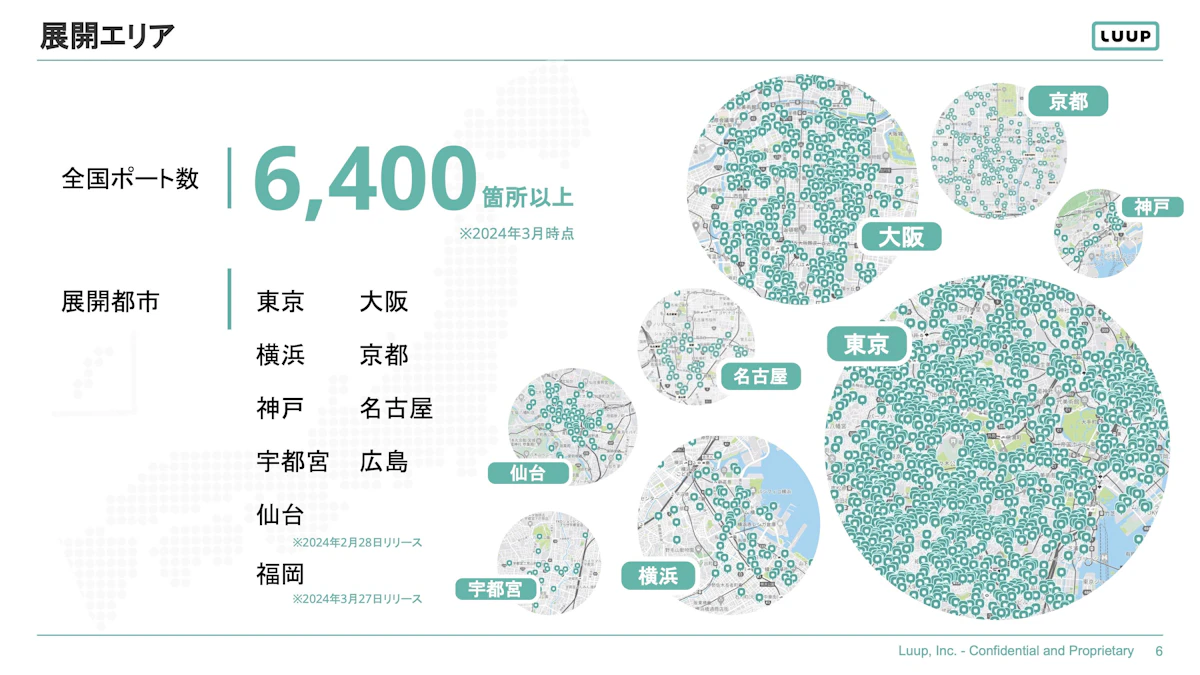
展開エリアとしては、2024年3月時点で6400カ所以上のポートを設置しています。場所は東京と大阪をメインに開始して、2024年の2月末に仙台をリリースしました。そして、3月27日に福岡を新しくリリースします。
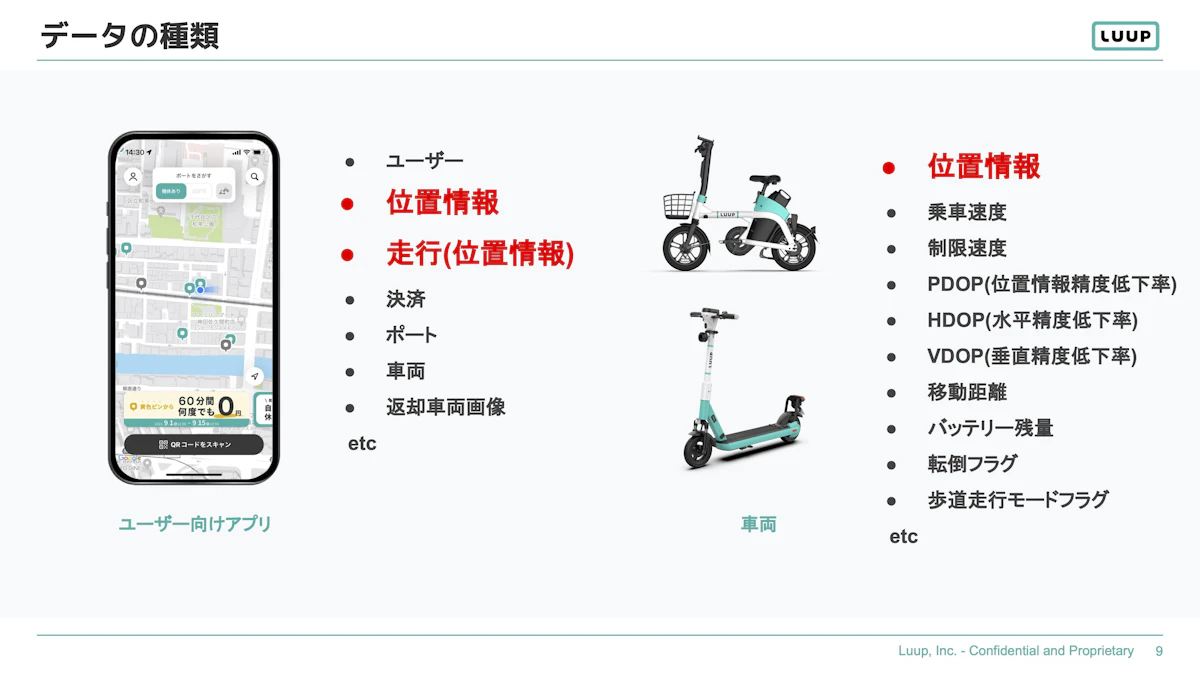
主にユーザー向けアプリと車両の2つから様々なデータが取得できます。
アプリからは主に位置情報や走行情報などのデータを取れます。車両では位置情報を始めとするIoTデータを取得しています。
スライドに記載しているもの以外にも、サードパーティー系のツールや社内のオペレーション用に展開している社内向けアプリから取れるデータなどもあります。
今回は位置情報のデータ取得にフォーカスします。
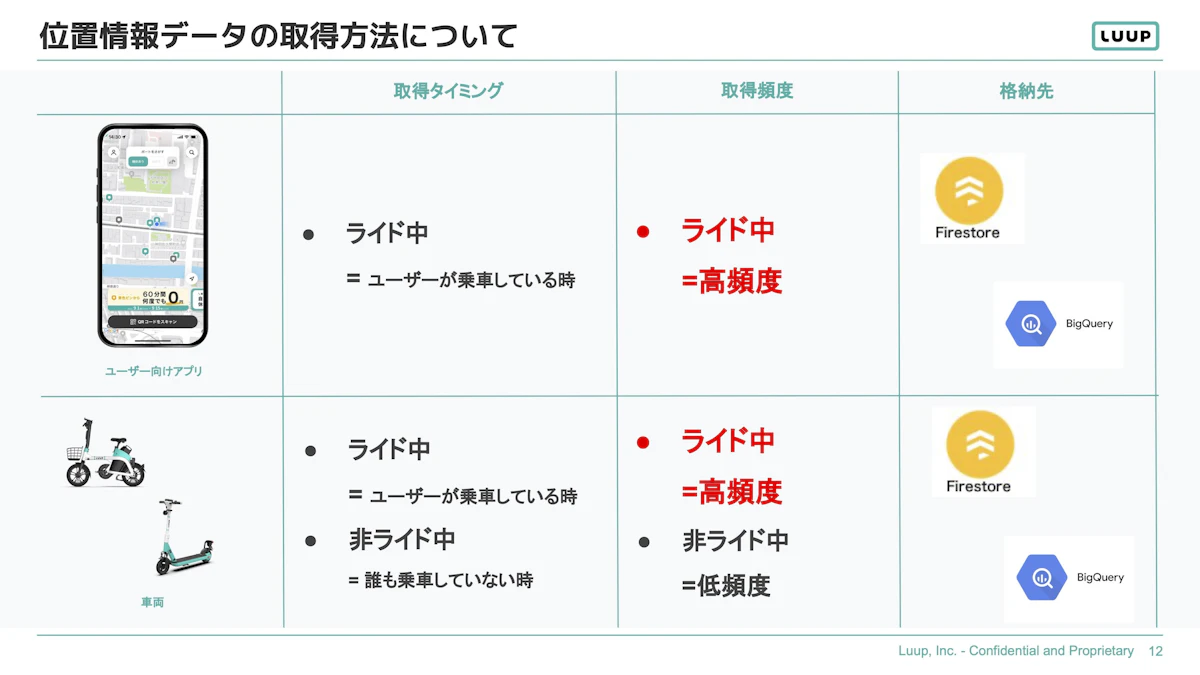
位置情報はユーザー向けアプリと車両の両方から取得しています。
ユーザー向けアプリでは、ライド中(ユーザーの乗車)の時のみに位置情報データをかなりの頻度で取得しています。 取得したデータはFirestoreに格納して、そこからストリーミングでBigQueryに流していく形です。車両では、ライド中と非ライド中(ポートに車両が置いてある時)の両方で位置情報データを取得しています。
取得頻度については、ライド中は非常に高頻度で、非ライド中はライド中よりも低頻度でデータを取得しています。格納先は同じくFirestoreを基準にBigQueryに流しています。
今回は特にライド中の時のデータの流れについて話します。
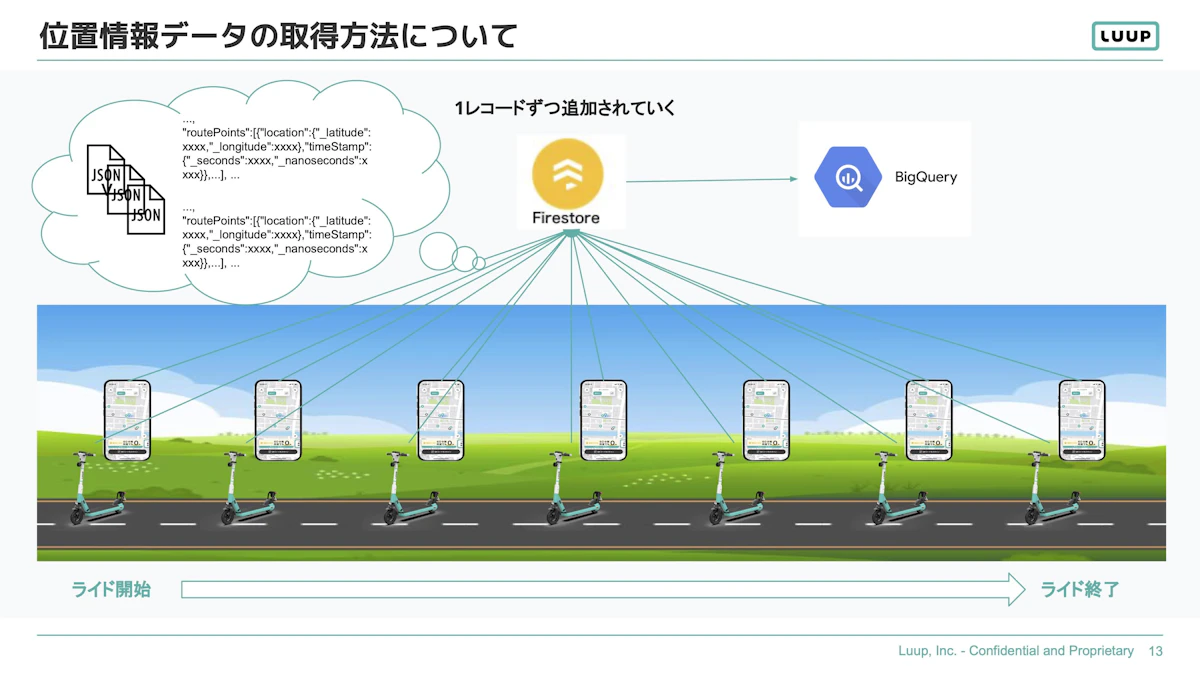
ライド開始から終了まで高頻度にFirestoreに位置情報データが流れています。
FirestoreがNoSQLのデータベースなので、1レコードずつ入ってきたデータがBigQueryにどんどん流れていくという仕組みです。
位置情報データを分析・活用する時にコストが高くなってしまうのが当初の課題でした。
単純にスキャンするデータ量が多すぎたのが原因でした。データが続々と1つのテーブルに入るので、ある日のあるライド経路を見たいだけの時も多くのスキャン量が必要になっていました。
また、経路以外のライド料金の支払いやクーポンの使用の実績だけを見たい場合でも同様のスキャン量が発生していました。
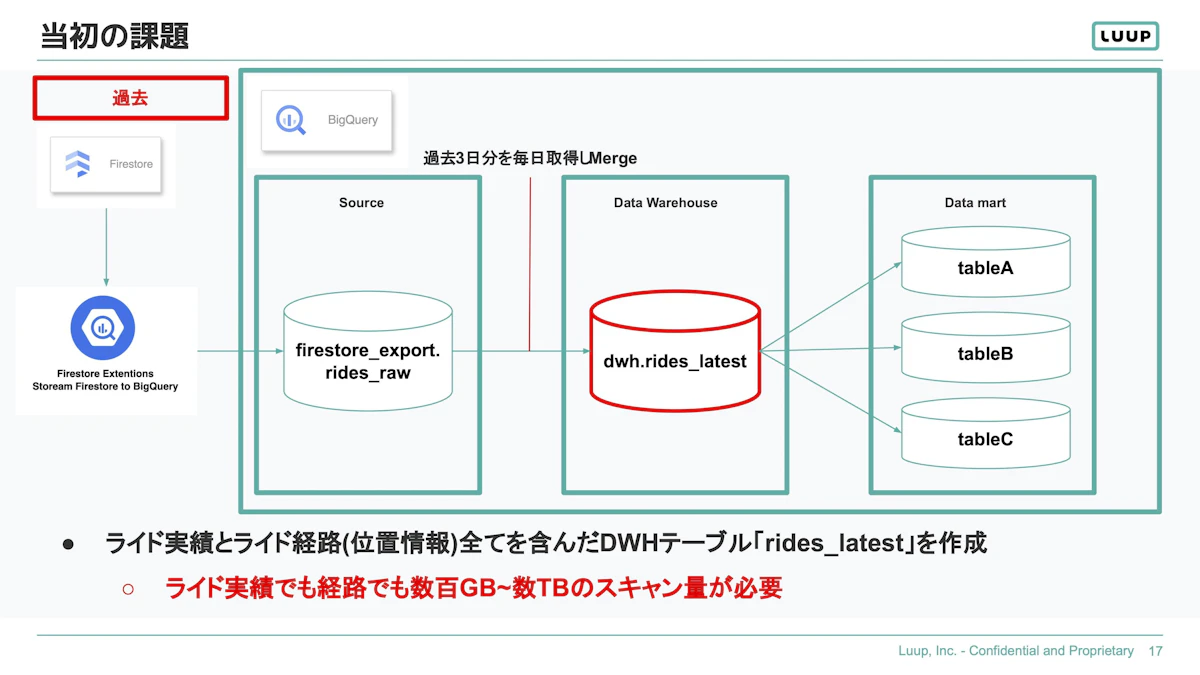
データ基盤で言うと、Firestoreにまずデータが入っていきます。
FirestoreからFirestoreのExtensionsという拡張機能を使ってBigQueryにデータがリアルタイムで流れます。 そこからData Warehouse層に別途テーブルを用意して、生データから過去3日分だけ取得して既存のテーブルにマージしていき、DWHテーブルを基準にそれぞれファクトテーブルをどんどん量産していく構造でした。
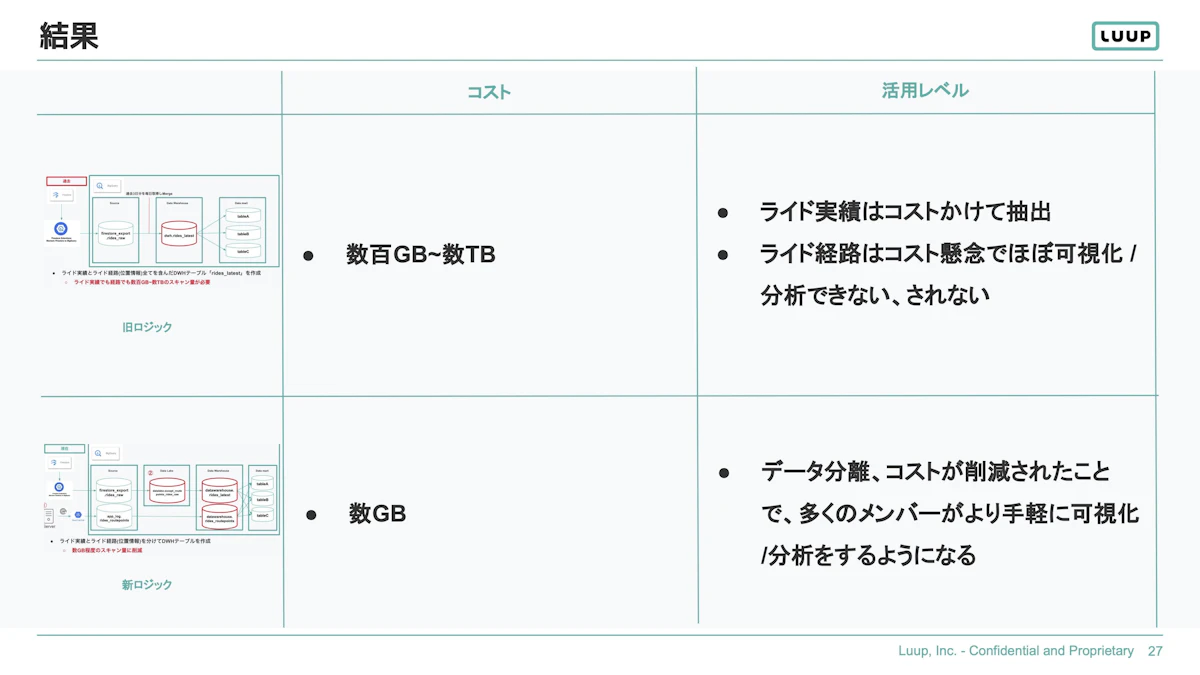
問題なのが、2つのテーブル「rides_raw」と「rides_latest」の容量です。1つのテーブルに位置情報のレコードが増えて入っていくので、特定の日の特定のデータを取る時も数百GBから数TB級のスキャン量が必要でした。
弊社のビジネスモデル的には、1つのライドで多くの位置情報が入ってくるので、ライド数が増えるにつれてデータ量が爆発的に増えていきます。
データ量が増えていくとスキャン量も増えて、分析するのにコストが増えていくのが課題でした。
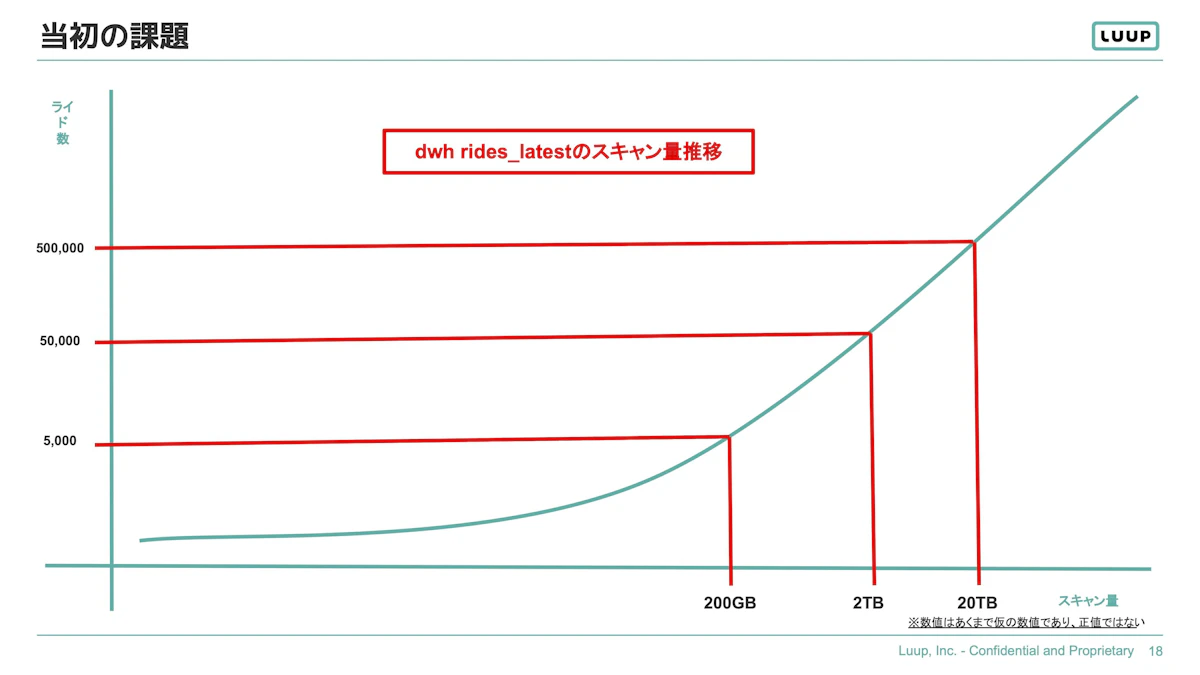
当時のチーム内ではあまり良い解決策が見つかりませんでした。当時は200GBくらいだったので大丈夫だと思っていましたが、それだとダメだよねという話になりました。
ライドによって得られるデータは会社を成長させる最もコアなデータなので、問題になった時に対処していたら負債が膨れ上がった時に手遅れになる可能性がありました。
そうならないために早めにコスト最適化を検討して、テーブル構造を作り変えていくことにしました。
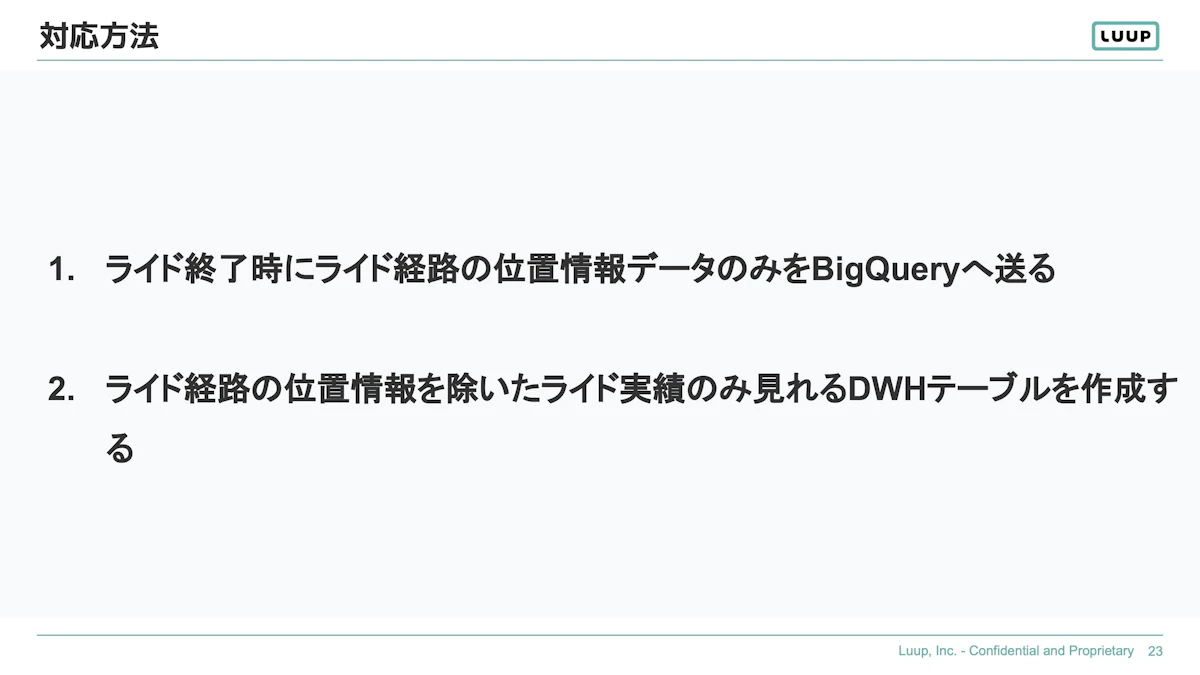
対応方法のポイントは2つです。
ライド終了時にライド経路の位置情報データのみをBigQueryに送るAPIを作ったのが一つ目です。そして、ライド経路の位置情報を除いてライド実績のみを見れるテーブルを別途用意したのが二つ目です。
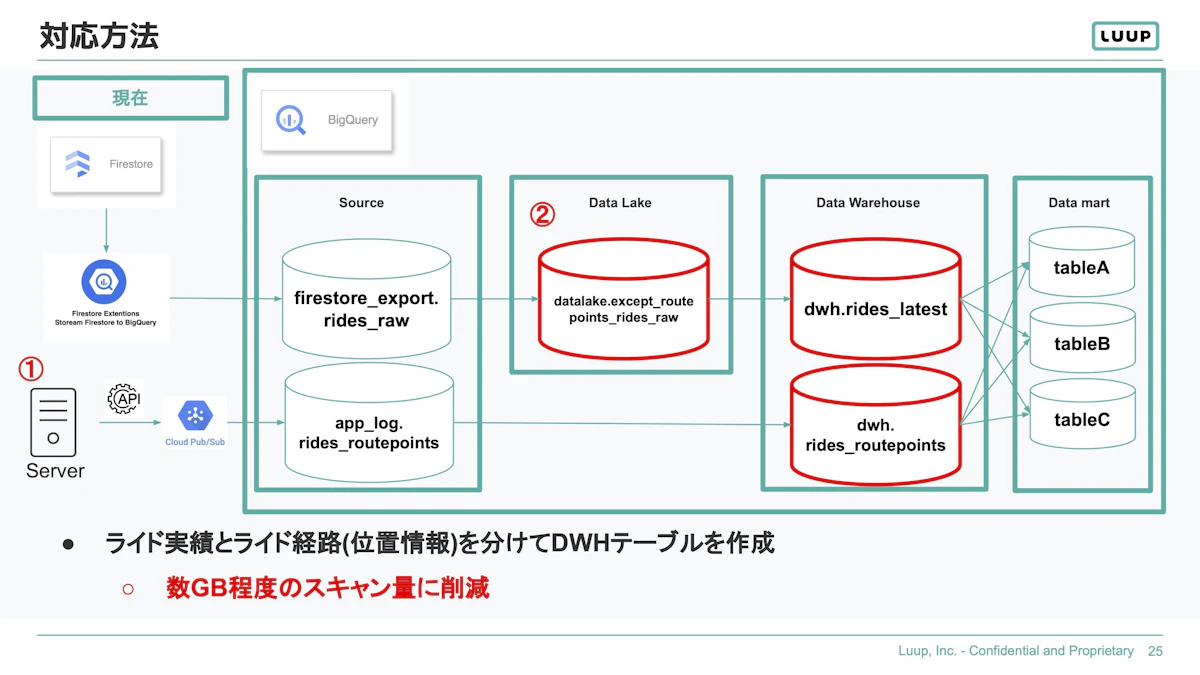
既存のFirestoreから取れるライドの生データの他に、ライドが終了したタイミングで位置情報データのみを取得するAPIをCloud Pub/Sub経由で流して、APIで取得したデータを格納するために「rides_routepoints」というテーブルをBigQueryのSourceテーブルに追加で用意しました。
既存のFirestore Extensionsで取れるテーブル「rides_raw」ではルートポイントを除いて、レコード数をかなり削減するData Lakeのテーブル「except_routepoints_rides_raw」を用意しました。そこからライドの実績とライドの経路を別々にするDWHテーブルを用意しました。
結果的に、数GB程度のスキャン量でデータが取得できました。また、ライドの実績と位置情報でテーブルを分割できたので、データの可視化や分析がしやすくなりました。
今回の事例を踏まえて、実装当初でもコストを軽視しない方が良いと学びました。リリース時点で問題が無くても、事業成長も視野に入れた長期的な目線で考えた上で、将来も対応できる最適なテーブル構造を作っておくのが重要です。
あとは、手のつけられない負債になる前に対処しましょう。負債が積もってから対応するのではなくて、前もって最適解を見つけて、取り返しがつかなくなる前に対処することがポイントです。
――ここからは視聴者の方からの質問に回答していきます。まず一つ目は「コストや負債への対応の意思決定は誰がどのように進めていかれたのでしょうか」とのことですが、いかがでしょうか。
僕の入社当時のデータエンジニアリングチームは2人しかいなくて、基本的にはサーバーやアプリ側と密に連携できていたので、僕が旗振り役として先頭に立ちました。
――続いて、「今回のデータでは、手がつけられなくなる負債の判断基準は具体的に何かあったのでしょうか」とのことですが、いかがでしょうか。
今回の事例ではライドデータだったことがポイントですね。ライドデータは我々にとって最重要データなので、事業成長に伴ってスキャン量も増えて分析ができなくなる状態はNGだったんです。 なので、時間をかけてでもコスト削減して分析できるようにするという決断に至りました。
――続いて、「BigQueryのテーブルを分ける以外に出た案はありますか」とのことですが、いかがでしょうか。
特に無かったですね。当時は改善案がチームでも出てこなくて、サーバーチームと議論してようやく出てきた結論でした。
――続いて、「既に保存されてるデータは分割後のテーブルに入れ直しましたか」とのことですが、いかがでしょうか。
基本的には過去データも全部マイグレーションする形で入れ直しました。
AI 時代のエンジニア転職は Offers で
あなたのキャリアに合った求人やスカウトが届く、エンジニア向け転職サービスです。
無料ではじめる正社員の求人を探す
Offers Jobs で正社員の求人を探せます。
求人を見る
AIに画面を作らせても、人のレビューは要るのか。デザインハーネスを提唱するこぎそ様が、4層モデルとデモ、レビューコメントから判断基準を育てる実践、人が判断を残すべき領域を語りました
株式会社Lumilinks 代表取締役 / デザイナー
こぎそ 他1名
設計・実装がAIに移った今、人間に残る要求・要件定義をどう考えるか。『良いコード/悪いコードで学ぶ設計入門』著者のミノ駆動様が、文脈・未知の未知・アウトカム・仮説推論の4つの思考と、現場の問いへの答えを語りました
合同会社DMM.com
ミノ駆動 他1名
#GTMLab主宰のなかむらまこと氏とLayerXの飯沼広基氏が登壇。GTMエンジニアは何をエンジニアリングするのか、なぜエンジニア出身が向いているのかを、効率化ではなく売上を伸ばす開発の実践とともに語りました。
#GTMLab 主宰
なかむら まこと 他2名
AIがコードを書く時代にORMをどう選ぶか。KyselyとD1でDBを2回吹き飛ばした溝口浩二(coji)様と、DrizzleとAtlasでスキーマだけを見るKenn Ejima様が、型・マイグレーション・DB選定で人が担う判断を語りました
Dot Product AI, Inc. Founder
Kenn Ejima 他2名
【前編はこちら】 Contents1 ディスカッション・質疑応答1.1 【OSS
バーチャルテックポエマー
紅月/koduki 他1名
Connpass詳細はこちら アーカイブはこちら 2024年09月11日、株式会
バーチャルテックポエマー
紅月/koduki 他1名